Affinitetsmodellering som vi känner till den är enkel och effektiv, men produktmetadata kan utnyttjas bättre för att förutse den mest relevanta upplevelsen för användarna.
Som marknadsförare är det vårt jobb att analysera besökarnas beteenden samt de produkter de interagerar med för att få en bättre förståelse för hur allt hänger ihop. Med denna information kan vi sedan skapa upplevelser som verkligen ger genklang på individuell nivå.
Trots våra bästa ansträngningar blir det dock svårare att tillskriva enskilda interaktioner någon innebörd när besökarna Become exponerade för ett bredare utbud av varumärken, färger, stilar, priser med mera. Och ofta går engagemangets sanna natur förlorad i ett nät av komplexa data.
Denna utmaning – som ersatts av ett gissningsspel där olika kombinationer av målgruppsanpassningsvillkor testas i hopp om att matcha rätt upplevelse med rätt målgrupp – är anledningen till att affinitetsprofilering skapades. Genom att tilldela en användare ett poäng baserat på de metadata som är kopplade till en produkt som de har interagerat med kunde team bättre förutsäga de mest relevanta artiklarna för dem i framtiden.
Men trots sin glans är branschen fortfarande naiv i sin tillämpning och implementering. I det här inlägget förklarar jag var affinitet befinner sig i dag och belyser den enorma outnyttjade potentialen.
Profilering av användarpreferenser börjar med att varje interaktion med en digital egendom registreras och att sedan alla produktattributvärden som är kopplade till interaktionen samlas in.
Snabbguide: Exempel på signaler för användarpreferenser | |
Engagemangstyp: Användarens interaktion med produkten | Produktattributvärden: Kännetecken som beskriver produkten |
Produktvy Lägg i varukorg Köp Filtrera produktrutnätet Lägg till i önskelistan Anpassad interaktion | Färg: röd Kön: män Stil: T Kategori: löpning |
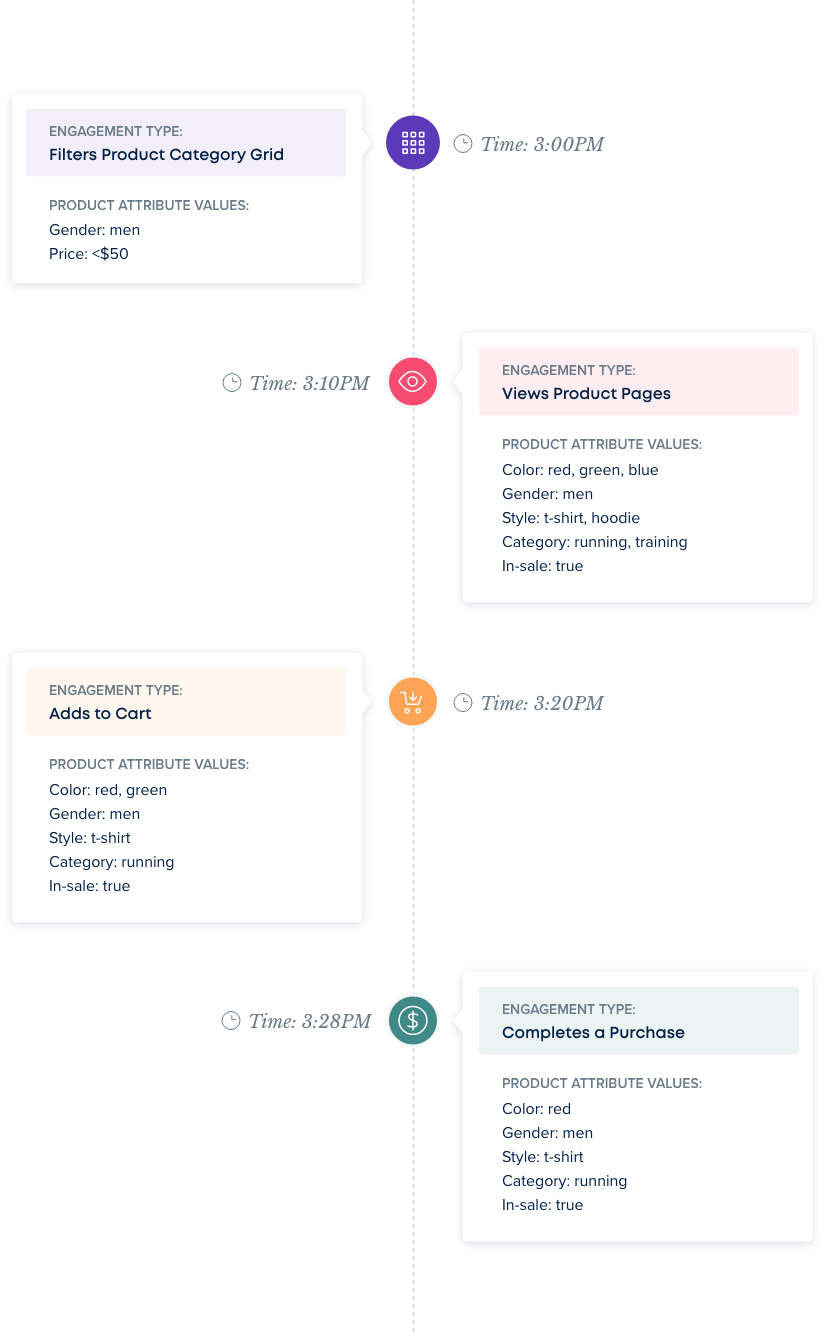
Låt oss till exempel titta på en exempelresa:
I samband med en enskild besökare kan vi se fyra sidvisningar där produktens färg var grön, sex där produkten var röd och två där den var blå. Dessutom bestod alla visade artiklar av t-shirten för män under 50 dollar. Besökaren lägger sedan två varor i sin kundvagn – en röd och en grön t-shirt – men köper till slut den röda.
| Attribut | Färg | Stil | kön | Prisintervall | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Värde: | Green | Röd | Blå | T | Tank | Cami | Men | Kvinnor | Pojkar | Flickor | <50 kr | >50 $ |
| Produktvy | 4 | 6 | 2 | 12 | 0 | 0 | 12 | 0 | 0 | 0 | 12 | 0 |
| Lägg i varukorg | 1 | 1 | 0 | 2 | 0 | 0 | 2 | 0 | 0 | 0 | 2 | 0 |
| Köp | 0 | 1 | 0 | 1 | 0 | 0 | 1 | 0 | 0 | 0 | 1 | 0 |
| Attribut: Färg | |||
|---|---|---|---|
| Värde | Green | Röd | Blå |
| Produktvy | 4 | 6 | 2 |
| Lägg i varukorg | 1 | 1 | 0 |
| Köp | 0 | 1 | 0 |
| Attribut: Stil | |||
|---|---|---|---|
| Värde: | T | Tank | Cami |
| Produktvy | 12 | 0 | 0 |
| Lägg i varukorg | 2 | 0 | 0 |
| Köp | 1 | 0 | 0 |
| Attribut: Kön | ||||
|---|---|---|---|---|
| Värde: | Men | Kvinnor | Pojkar | Flickor |
| Produktvy | 12 | 0 | 0 | 0 |
| Lägg i varukorg | 2 | 0 | 0 | 0 |
| Köp | 1 | 0 | 0 | 0 |
| Attribut: Prisintervall | ||
|---|---|---|
| Värde: | <50 kr | >50 $ |
| Produktvy | 12 | 0 |
| Lägg i varukorg | 2 | 0 |
| Köp | 1 | 0 |
Hela sessionen kan se ut ungefär så här, där alla attributvärden och engagemangstyper som ska bevägas har markerats för poängsättning.
Varje gång en användare interagerar med en produkt uppdateras poängen för varje attributvärde av typen av interaktion med den samt när den inträffade.
För att ovanstående data ska Become meningsfull måste man först fastställa ett samband mellan användarinteraktionen och ett attributvärde. Idag görs detta genom att tilldela varje engagemang en vikt baserat på dess antagna avsiktsnivå och sedan summera det totala antalet engagemang för varje värde.
Beroende på vänskapsalgoritm kan standardvikter kvantifieras på följande sätt.
Det är förståeligt att ju högre grad av avsikt som är förknippad, desto större vikt ges åt interaktionen. Att till exempel göra ett köp skulle få större vikt än att lägga till en vara i varukorgen, vilket i sin tur väger tyngre än att bara titta på en produkt. Därefter multipliceras förekomsten av varje interaktion med vikten.
Engagemangsresultat = interaktionstypens vikt × antal attributvärden
Om inköpsvikten är 4, lägg till i varukorg är 2 och produktvisning är 1, blir den totala poängen för värdet ”color:red” (1 × 6) + (2 × 1) + (4 × 1) = 12.
| Vikt | Färg | |||
|---|---|---|---|---|
| Green | Röd | Blå | ||
| Produktvy | 1 | 4 | 6 | 2 |
| Lägg i varukorg | 2 | 1 | 1 | 0 |
| Köp | 4 | 0 | 1 | 0 |
| Poäng | 6 | 12 | 2 | |
Dessa poäng kan nu användas för att bygga upp en affinitetsprofil, vilket i princip rangordnar en lista över föredragna produktfärger, kategorier, varumärken och så vidare baserat på kundens aktivitet.
Eftersom användarnas beteende och preferenser förändras över tid måste affinitetsprofilerna finjusteras i realtid med varje ny sidvisning, åtgärd och händelse. Därför beaktas även hur nyligen en interaktion ägde rum, vilket säkerställer att algoritmen gynnar nyare aktivitet framför äldre data.
Tre tidsperioder används vanligen vid poängsättning:
När denna information vägs in i attributvärdespoängen multipliceras förutom interaktionsvikten även aktualitetsvikten.
Recency score = recency weight (interaktionsvikt x antal attributvärden)
Om vi antar att samma användare som nämns ovan återvänder till webbplatsen två veckor senare och köper den gröna t-shirten som tidigare lämnats i varukorgen, blir den totala poängen för ”färg: grön” 2[(1×4) + (2×1) + (4×0)] + 8(4×1) = 44.
| Attribut | Färg | ||||
|---|---|---|---|---|---|
| Aktualitet | Värde: | Vikt: | Green | Röd | Blå |
| Senaste historik (vikt = 2) | Produktvy | 1 | 4 | 6 | 2 |
| Lägg i varukorg | 2 | 1 | 1 | 0 | |
| Köp | 4 | 0 | 1 | 0 | |
| Poäng | 6 × 2 = 12 | 12 × 2 = 24 | 2 × 2 = 4 | ||
| Realtid (vikt = 8) | Köp | 4 | 1 | 0 | 0 |
| Poäng | 4 × 8 = 32 | 0 | 0 | ||
| Total poäng | 44 | 24 | 4 | ||
| Recency: nyligen utförd historik (vikt = 2) | |||
| Attribut: | Färg: | ||
|---|---|---|---|
| Produktvy Vikt: 1 | 4 | 6 | 2 |
| Lägg till i varukorg Vikt: 1 | 1 | 1 | – |
| Köp Vikt: 1 | 0 | 1 | 0 |
| Poäng | 6 × 2 = 12 | 12 × 2 = 24 | 2 × 2 = 4 |
| Senaste aktivitet: Realtid (vikt = 4) | |||
| Attribut: | Färg: | ||
| Green | Röd | Blå | |
| Köp Vikt: 4 | 0 | 1 | 0 |
| Poäng | 4 × 8 = 32 | 0 | 0 |
| Total poäng | 44 | 24 | 4 |
Nu återspeglar affinitetsprofilen två starka poäng (engagemang och aktualitet), vilket gör det möjligt för oss att visa produkter som användaren med större sannolikhet kommer att engagera sig i vid givna tidpunkter. Genom normalisering av surfdata går det till och med att upptäcka ”long tail”-attribut som korrelerar med ett köp, vilket säkerställer att resultaten inte snedvrids av att ofta förekommande eller ständigt populära attribut nedprioriteras.
Den enkla metod för affinitetsberäkning som beskrivs ovan är enkel och effektiv – den utnyttjar tillgängliga produktmetadata för att bättre avslöja samband mellan attribut från olika produktfält baserat på de två ljusa formlerna ovan. Detta gör det enkelt att kommunicera med intressenter och därmed betona vikten av attribut av god kvalitet i produktflödet – det integrerar dessutom nyligen lanserade produkter på ett naturligt sätt, utan behov av ytterligare installation eller konfiguration. Men framtiden för affiniteter är mycket mer flexibel tack vare maskininlärning, vilket ger nya möjligheter att uppnå högre rangordningskraft och upptäcka mer komplexa samband.
Dessa smarta affiniteter kan justera de variabler som används för att beräkna poäng, i stället för att utnyttja samma formel med ett statiskt viktringssystem för alla besökare. Till exempel genom att justera vikten för ett attribut så att fokuset ligger på långsiktigt beteende, medan ett annat är inriktat på den aktuella sessionen. Genom att tränas på tidigare kundsessioner som har lett till konvertering kan djupinlärningsmodeller tilldela vikter till olika interaktioner och tidsramar för varje attribut samt upptäcka samband mellan attribut. Baserat på en användarsession i realtid kan den sedan rangordna ett attributvärde, till exempel färg, efter sannolikheten för att det läggs i varukorgen eller köps, även för färger eller varumärken som personen inte har exponerats för tidigare. Och tack vare en högre grad av datanormalisering kommer viktiga kontextuella nyanser som webbplatstyp och produktutbud, datum och tid att tas i beaktande under beräkningarna.
Man kan säga att preferensmodellering blir avsevärt mer personligt anpassad. Och med en så stor variation behöver teamen mycket bättre insyn i hur preferenser genereras, analyseras och omsätts i handling. Idag finns de flesta uppgifter om preferenser i en svarta lådan, vilket innebär att de som använder dem för att optimera sina personaliseringsinsatser har mycket liten insikt i hur algoritmen har beräknat en preferenspoäng. Men ”det här är din intressepoäng, ta det eller lämna det” räcker inte längre. All data om intressen och attribut bör exponeras, anpassas och göras personlig utifrån verksamhetens unika behov.
Det enda sättet att frigöra den fulla kraften hos användarpreferenser för att förutsäga vad en individ vill ha är att exponera och ge så mycket kontroll som möjligt över den informationen och hur den används. Därför är det viktigt att samarbeta med en teknikleverantör som inte bara låter dig experimentera med alla variabler för användarpreferenser och dra nytta av dem på relativt utförliga sätt, utan också gör att du förstår resultatet av dessa ansträngningar per kampanj.