I det här inlägget beskriver vi de grundläggande idéerna bakom bayesiansk statistik och hur de bidrar till de affärsbeslut som du behöver fatta i slutet av ett test.
Please accept functional cookies to watch this video.
A/B-testning är ett utmärkt sätt att jämföra alternativa upplevelser eller möjliga ändringar på er webbplats eller era digitala tillgångar. Genom att köra de två upplevelserna parallellt och slumpmässigt avgöra vilka besökare som landar på vilken version får du en ärlig jämförelse av vilken som presterar bäst.
När du har fått datainsikter från ditt test behöver du pålitliga och informativa sätt att sammanfatta dem och dra slutsatser. Det bayesianska synsättet på statistik är ett utmärkt sätt att uppnå detta.
Här beskriver vi de grundläggande idéerna bakom bayesiansk statistik och hur de bidrar till de affärsbeslut som du behöver fatta i slutet av ett test. Vi presenterar först metoden för analys av datainsikter.
Sedan illustrerar vi hur denna analys leder till naturliga lösningar på frågor som:
Vilken variant ger bättre resultat?
Hur mycket bättre är de resultaten?
Kan vi vara säkra på vår slutsats?
Tänk om vi vill testa fler än två varianter?
Vilken urvalsstorlek krävs för ett bayesianskt A/B-test?
Kan ett test avslutas i förtid om resultaten verkar entydiga?
Bayesiansk statistik är uppkallad efter reverend Thomas Bayes, som levde i Storbritannien på 1700-talet och som låg bakom beviset för Bayes sats. Den ledande principen inom bayesiansk statistik är att du kan använda sannolikhetsspråket för att beskriva allt vi inte vet och vill lära oss av datainsikter. Som vi kommer att se är detta ett idealiskt språk för att diskutera många av de frågor som är viktigast för affärsbeslut.
När du kör ett A/B-test är det primära målet att ta reda på vilken variant som är effektivast. För att göra det jämför du resultaten med de två metoderna. Den Bayesianska analysen börjar med att titta på nyckeltalen för var och en av varianterna. Resultaten ger oss information om deras värde men lämnar alltid viss osäkerhet. Vi beskriver osäkerhet med hjälp av en sannolikhetsfördelning. Vi kan simulera resultat från fördelningen för att förstå hur den ser ut.
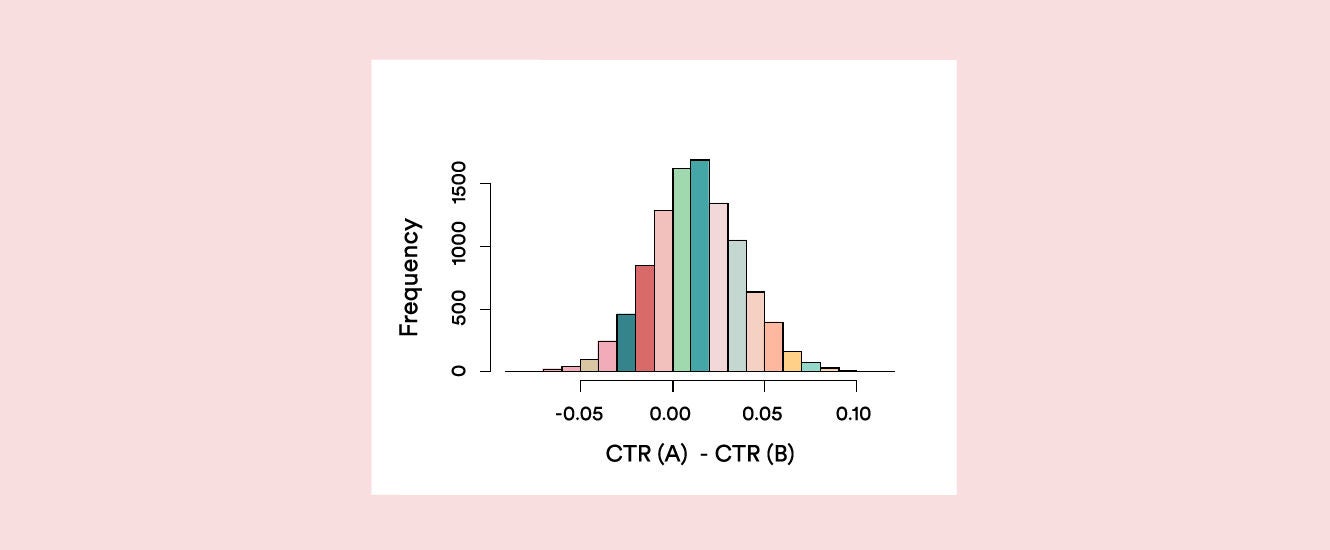
Histogrammet i figur 1 är typiskt för det du kan få fram från din analys. Den visar den statistiska fördelningen av skillnaden i klickfrekvens (CTR) mellan A och B. Större delen av kurvan ligger till höger om 0, vilket tyder på att A har en högre CTR. Den del av kurvan som ligger till höger om 0 är en bra sammanfattning av det beviset – det kallas Probability to Be Best (P2BB). I figur 1 är P2BB 0,699 till förmån för version A.
Om du har tre eller fler varianter är det fortfarande enkelt att beräkna sannolikheten för att vara bäst (P2BB), där sannolikheten delas upp i tre delar, en för varje variant.
Du måste starta den bayesianska motorn med en a priori-sannolikhetsfördelning som återspeglar din uppfattning om nyckeltalet innan du ser några datainsikter. A priori-värdet kombineras sedan med dina testdatainsikter för att få fram en a posteriori-fördelning för varje variant. Figur 1 skulle vara a posteriori-fördelningen för skillnaden mellan variant A och B; detta återspeglar den aktuella bilden efter att ha sett datainsikterna.
Du behöver prior för att få det att fungera, men när mängden datainsikter är stor – vilket nästan alltid är fallet i A/B-tester – domineras prior snabbt av dem och ”glömmer” i praktiken prior; därför behöver du inte lägga alltför mycket tanke på hur du väljer prior. Det går att arbeta med vissa standardval av priorer utan att analysen påverkas.
Men kan man verkligen ange en prioriterad fördelning och vad man tror i förväg?
Detta har säkerligen varit en källa till friktion mellan personer i de olika statistiska lägren, så det är till hjälp att jämföra det bayerska sammanhanget med det ”klassiska”, frekventistiska synsätt som du kan ha stött på i en inledande statistikkurs. I det klassiska synsättet är antingen A bättre än B, B bättre än A eller så är de identiska. Frågan ”vad är sannolikheten för att A är bättre” ingår inte i lexikonet. Det går inte att ge något svar, och faktum är att du inte ens tillåts ställa frågan!
Det klassiska paradigmet använder visserligen sannolikhet, men endast för att beskriva insikterna i experimentdata, inte för att sammanfatta vad du vet om ett nyckeltal. Det är därför du inte kan göra en sammanfattning som "sannolikheten för att B ger ett positivt uppsving jämfört med A är 98 %".
I de flesta A/B-tester får man massor av datainsikter. Därför är det inte längre särskilt kontroversiellt, eftersom allt du stoppar in för att få igång den Bayesianska motorn i i stort sett kommer att sköljas bort av den informationen, som verkligen kommer att vara den komponent som dominerar det du till slut får. Och det är därför vi anser att de Bayesianska sammanfattningarna lämpar sig så mycket bättre för affärsbeslut.
Personer som ser alternativ A bör på sätt och vis vara så lika dem som ser alternativ B som möjligt. Det är sedan länge väl become i den vetenskapliga litteraturen, med början i statistikern Ronald Fishers arbete för ungefär 100 år sedan, att det bästa sättet att uppnå detta är att se till att du väljer rätt trafikfördelning.
Fundera därför på vilka alternativ som ligger på bordet. Om någon besöker er webbplats måste ni bestämma vilken landningssida en besökare får se. Det kan du styra genom att fördela en på slumpmässiga grunder mellan de två grupperna. Du måste ha en motor till ditt förfogande – ett ramverk som gör att du kan göra dessa slumpmässiga fördelningar. Det garanterar en rättvis jämförelse.
För att validera de datainsamlingar som du gör måste du säkerställa att denna slumpmässiga fördelning sker, eftersom den fastställer ett visst kausalt samband för vad som påverkar användarnas beslut. Om du till exempel ger de unga version A och de äldre version B, och du ser en skillnad, kommer du aldrig att få veta om det beror på deras ålder eller på webbsidans design. Det kallas för att resultatet förvrängs.
När du fattar dessa beslut är det viktigt att tänka på ”vad som kan gå fel” med testmotorn. Du vill att ditt test ska vara känsligt för eventuella buggar. Ofta beror buggar på att den slumpmässiga allokeringen misslyckas över tid, vilket gör att naturliga tidstrender i dina KPI:er snedvrider resultaten. Om det finns veckotrender i dina datainsikter måste du köra ett A/B-test i två veckor för att säkerställa att motorn hanterar dem på ett framgångsrikt sätt. Om det finns dygnstrender (men inga veckovisa sådana) har du råd att köra kortare experiment. Det kan också förekomma särskilda händelser som plötsligt ökar eller minskar antalet besökare på webbplatsen, eller förändrar besökssammansättningen, vilket påverkar prestandan för en upplevelse. Du kanske vill avvakta med att fatta några beslut tills du ser om sådana problem har en inverkan på dina resultat.
De överväganden som nämns ovan indikerar en minsta tidsram för att köra experimentet, vilket säkerställer en representativ täckning i A/B-testet av typiska framtida webbplatsbesökare. Ofta är det dessa som avgör hur länge testet pågår.
Urvalsstorleksparadigmet för bayesiansk testning ställer frågan om hur smala du vill att dina slutliga sannolikhetsfunktioner ska vara. Du vill förmodligen fokusera på sannolikhetsfunktionen för skillnaden i nyckeltal mellan de två varianterna, vilket visas i figur 1. Och du har säkert redan en uppfattning om vilken typ av skillnad som kan vara viktig för din verksamhet; det ger en riktlinje för hur smal funktionen ska vara – ju tightare intervall, desto mer vet du.
Det är viktigt att notera att du kan ha ett snävt intervall, men om de personer som tittade på webbplatsen var en del av randomiseringsundergruppen kommer det du får fram inte att gälla för allmänheten. Så du bör verkligen arbeta på båda fronterna. Det ena är: hur mycket information har du? Ju snävare intervall, desto mer informativt är det. Men hur generaliserbar är den information som du tillhandahåller?
Båda dessa aspekter är viktiga och kan vara avgörande för hur stor ett experiment måste vara. En webbplats med mycket hög trafik kan snabbt nå den nödvändiga urvalsstorleken utan att ge en fullständigt representativ bild av alla besökare. Och detta kan också fungera omvänt, så att när du har uppnått önskad urvalsstorlek har du redan gått igenom flera tidsperioder. Du måste se hur båda dessa faktorer fungerar och vägs mot varandra.
Du behöver tillhandahålla information om sannolika värden för KPI:erna. Ofta körs en av versionerna redan, så du kan använda historiska datainsikter för detta ändamål. För nya versioner behöver du fundera på vilken effekt de kan ha. Om testet omfattar flera versioner gäller samma idéer och samma indata krävs.
De grundläggande indata som krävs för att beräkna ett urvalsstorlek beror på KPI:ns karaktär:
För binära nyckeltal som klickfrekvens (CTR) eller installationsfrekvens behöver du bara de förväntade frekvenserna för varje version
Om du tittar på rent kontinuerliga KPI:er som intäkt per konvertering måste du tillhandahålla en uppskattning av både den typiska konverteringsstorleken och variationen i storlek bland dem som faktiskt konverterar
För ett ”blandat” nyckeltal som intäkter per besökare behöver du genomsnittet, variationen och en uppskattning av andelen som kommer att konvertera.
Det finns enkla formler som du kan använda för att fastställa urvalsstorleken, liksom användbara kalkylatorer för urvalsstorlek vid A/B-tester. Övervägandena som anges ovan anger en minsta tidsram för att köra ditt experiment som säkerställer representativ täckning i A/B-testet av typiska framtida webbplatsbesökare. Ofta är det dessa faktorer som styr testets tidslängd.
Formlerna för urvalsstorlek är desamma, men här skiljer vi på två mål: (1) att hitta det bästa och (2) att visa att standardversionen inte är den bästa.
Vad är annorlunda med det andra målet?
Anta att du har två nya versioner som du vill jämföra med standardversionen. Din bästa gissning ger nästan samma förväntade nyckeltal för var och en av de nya versionerna, där båda innebär en förbättring jämfört med standardversionen. Med mycket liknande nyckeltal behöver du ett stort urval för att veta vilken av de två nya versionerna som är bättre än den andra. Men om du förväntar dig att båda ska vara bättre än standardversionen kan du ”räkna bort” standardversionen med ett mycket mindre test.
För att illustrera idén ytterligare:
Den aktuella upplevelsen har en klickfrekvens (CTR) på 1 %. En ny version föreslås i förhoppning om att den ska öka klickfrekvensen (CTR) till 1,2 %. Den förväntade skillnaden är 0,2 %, så du behöver ett A/B-test som visar vad den verkliga skillnaden är med högre upplösning. En bra tumregel är att sikta på en upplösning som koncentrerar 95 % av den a posteriori-fördelningen i ett intervall som motsvarar storleken på den förväntade skillnaden.
I det här exemplet innebär det att minska skillnaden så att du kan vara 95 % säker på ett intervall med längden 0,002. För att uppnå den här nivån av träffsäkerhet behöver du ett urval på 83 575 besökare på båda sidorna. Vad händer om ens en förbättring av klickfrekvensen (CTR) på 10 % till 1,1 % är avgörande? Då behöver du känna till skillnaden på upp till som mest 0,1 %. Det kräver en urvalsstorlek på 319 290 för varje version.
Nu ska vi titta på ett exempel som handlar om intäkter per besökare:
Ett vanligt scenario (som ofta kallas paretoprincipen) är att de flesta besökare inte genererar några intäkter, och bland dem som gör det drar ett litet antal ”stora fiskar” upp genomsnittet samt standardavvikelsen.
Den aktuella landningssidan har en konverteringsgrad på 1 %; i genomsnitt spenderar konverterare 20 $; standardavvikelsen för konverterares köp är 25 $. Det innebär att de genomsnittliga intäkterna per besökare är 0,20 $. Marknadsföringen tror att den nya versionen kommer att locka fler köpare, vilket höjer konverteringsgraden till 1,2 %, men att andelen ”storfiskar” minskar så att den genomsnittliga konverteringen sjunker till 19 $ och standardavvikelsen till 22 $.
Det motsvarar en genomsnittlig intäkt på 0,228 $, en förväntad förbäkring på 0,028 $ per besökare. A/B-testet måste vara tillräckligt stort för att begränsa det 95-procentiga konfidensintervallet för skillnaden i genomsnittlig intäkt till högst den förväntade skillnaden, det vill säga till 0,028 $. Vi behöver 397 830 besökare för varje upplevelse för att uppnå den noggrannhetsnivån.
Vi rekommenderade ovan att ställa in urvalsstorleken för att styra bredden på det 95-procentiga konfidensintervallet. Det är lätt att minska risken för att missa en värdefull förändring genom att kräva en högre sannolikhetsnivå, säg 98 % eller 99 %, men på bekostnad av en ökad urvalsstorlek.
Sannolikheten för att A är bättre (eller sämre) än B utgör ett naturligt mått att följa i takt med att testet fortskrider. Och en stark signal från P2BB-statistiken kan användas som vägledning för tidig avstängning. Tidig avstängning måste dock göras med försiktighet.
För det första är den bayerska sammanfattningen inte helt immun mot tjuvstart. P2BB-värdet kommer att driva upp och ner under ett experiment. Detta gäller i synnerhet om det inte är någon skillnad i resultat mellan varianterna, som vid A/A-testning. I så fall kommer du att se att P2BB ökar och minskar när du samlar in fler datainsikter. Det faktum att det har passerat ett tröskelvärde (som 95 %) någon gång under testet är ingen garanti för att det förblir över tröskelvärdet om du väntar till den planerade sluttiden.
För det andra är det alltid riskabelt att stanna innan man har observerat minst en fullständig tidscykel. Version B kan vara bättre för besökare i början av cykeln, men sämre för dem som är längre fram i cykeln. Om du avbryter före slutet av en fullständig cykel kan dina resultat bli snedvridna.
Om du vill stoppa processen tidigt kan du överväga att använda striktare kriterier för en tidigare stoppunkt. Om du till exempel ser att sannolikheten blir extrem (säg över 0,999 eller under 0,001) kan du känna dig trygg med att stoppa och fatta ett beslut. Om det verkligen är skillnad på A och B kan du ändå räkna med att nå de trösklarna relativt snabbt.
Slutligen vill vi också upprepa hur viktigt det är att vänta på att tidstrender visar sig i ditt test. Du vill inte fatta ett beslut baserat på ett kort tidsfönster för att sedan upptäcka att resultaten är helt annorlunda senare på dagen eller i veckan – tänk dig att besökare på vardagar reagerar bättre på A än B, men att den trenden vänds under helgen. Att fatta ett beslut på en onsdag baserat på ett experiment som inleddes på tisdagen kan leda till ett dåligt beslut.