Att analysera resultaten av A/B-testning är ett av de viktigaste stegen i ett experiment. Men det är också det som det pratas minst om. Så gör du för att göra det rätt.
De flesta experimentplattformar har inbyggd analys för att spåra alla relevanta mätvärden och KPI:er. Men innan du analyserar en rapport om ett A/B-test är det viktigt att du förstår följande två viktiga mätvärden.
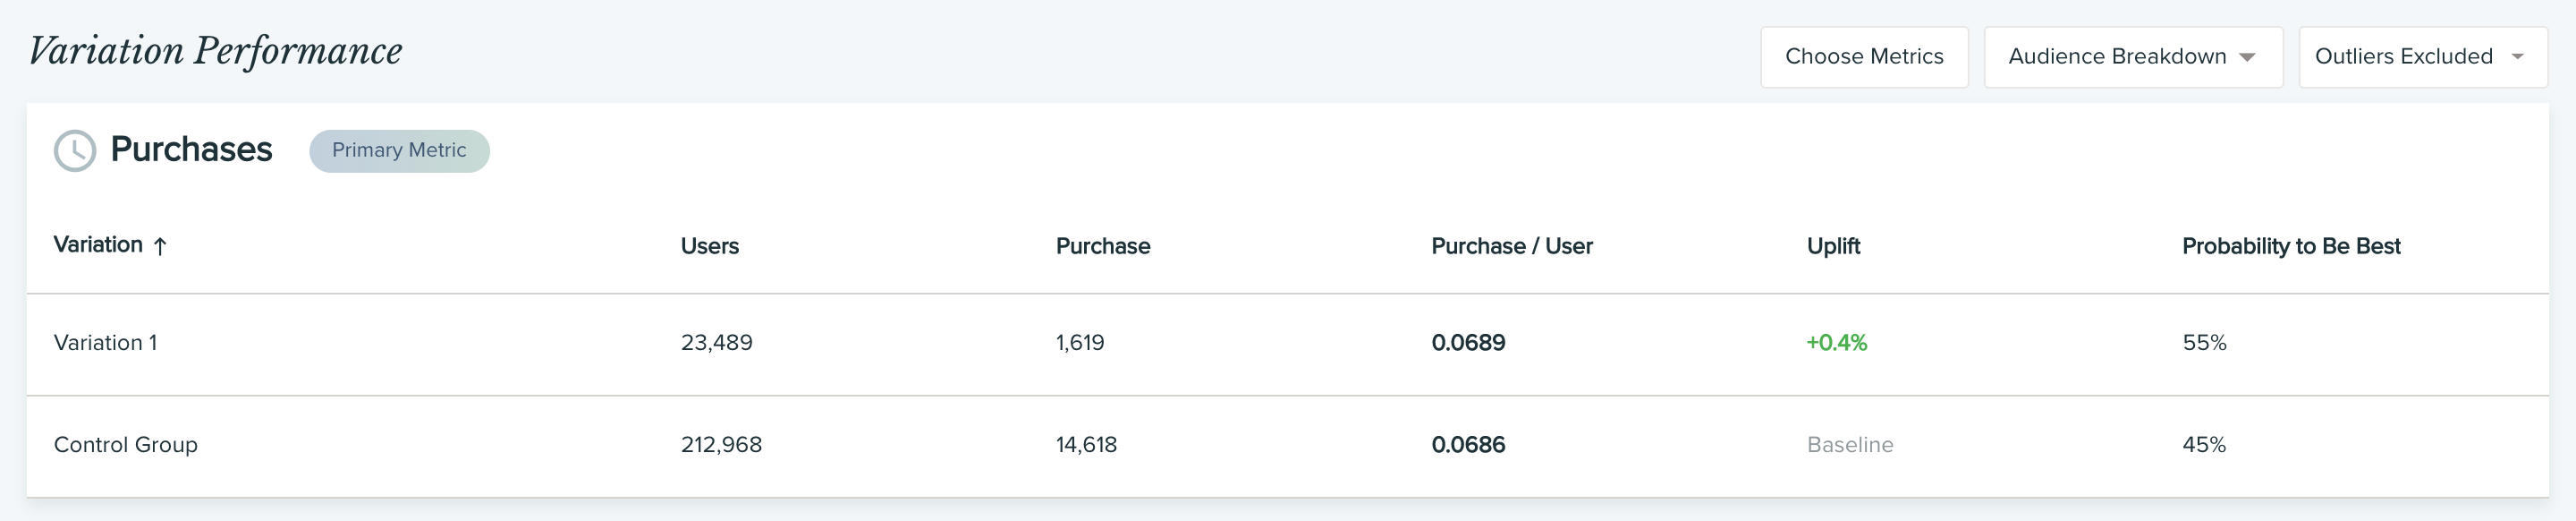
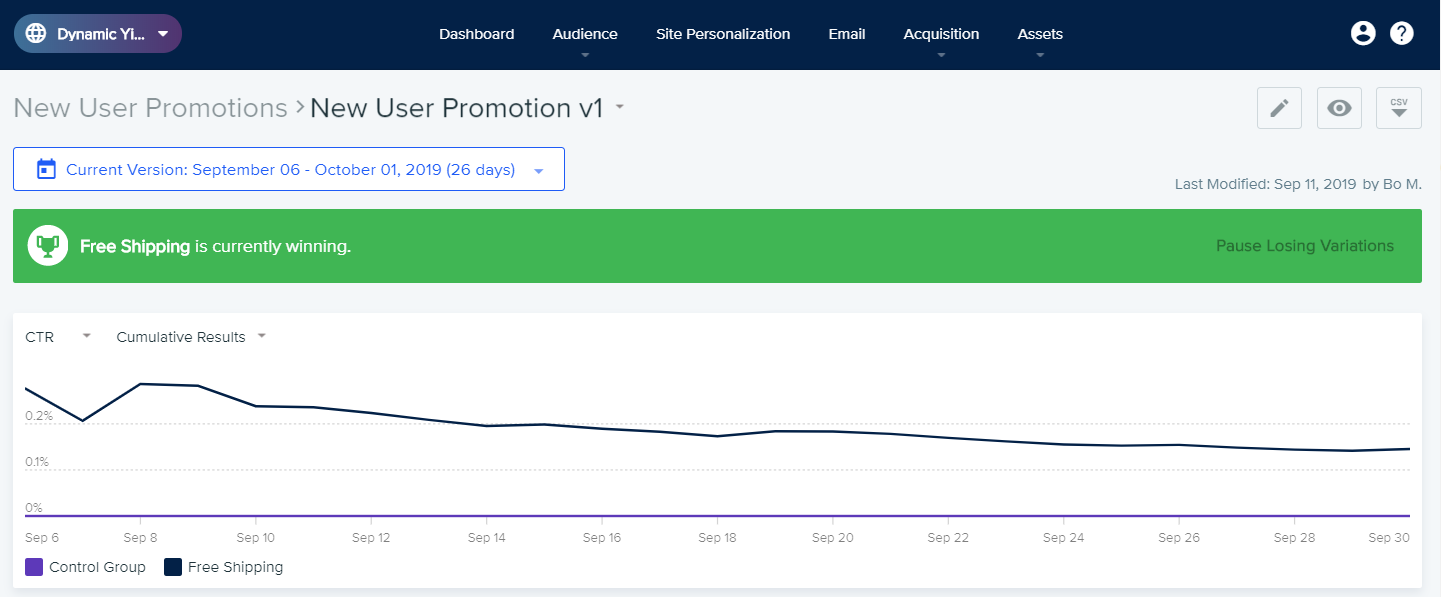
Börja med att titta på A/B-testresultaten för att se om en vinnare har utsetts, eller för annan information som vilken variant som för tillfället vinner. Om din experimentering inte tillhandahåller måttet Probability to Be Best kan du använda vår Bayesian A/B Testing Calculator för att undersöka data och leta efter statistiskt signifikanta resultat.
En vinnare utses vanligtvis om följande villkor är uppfyllda:
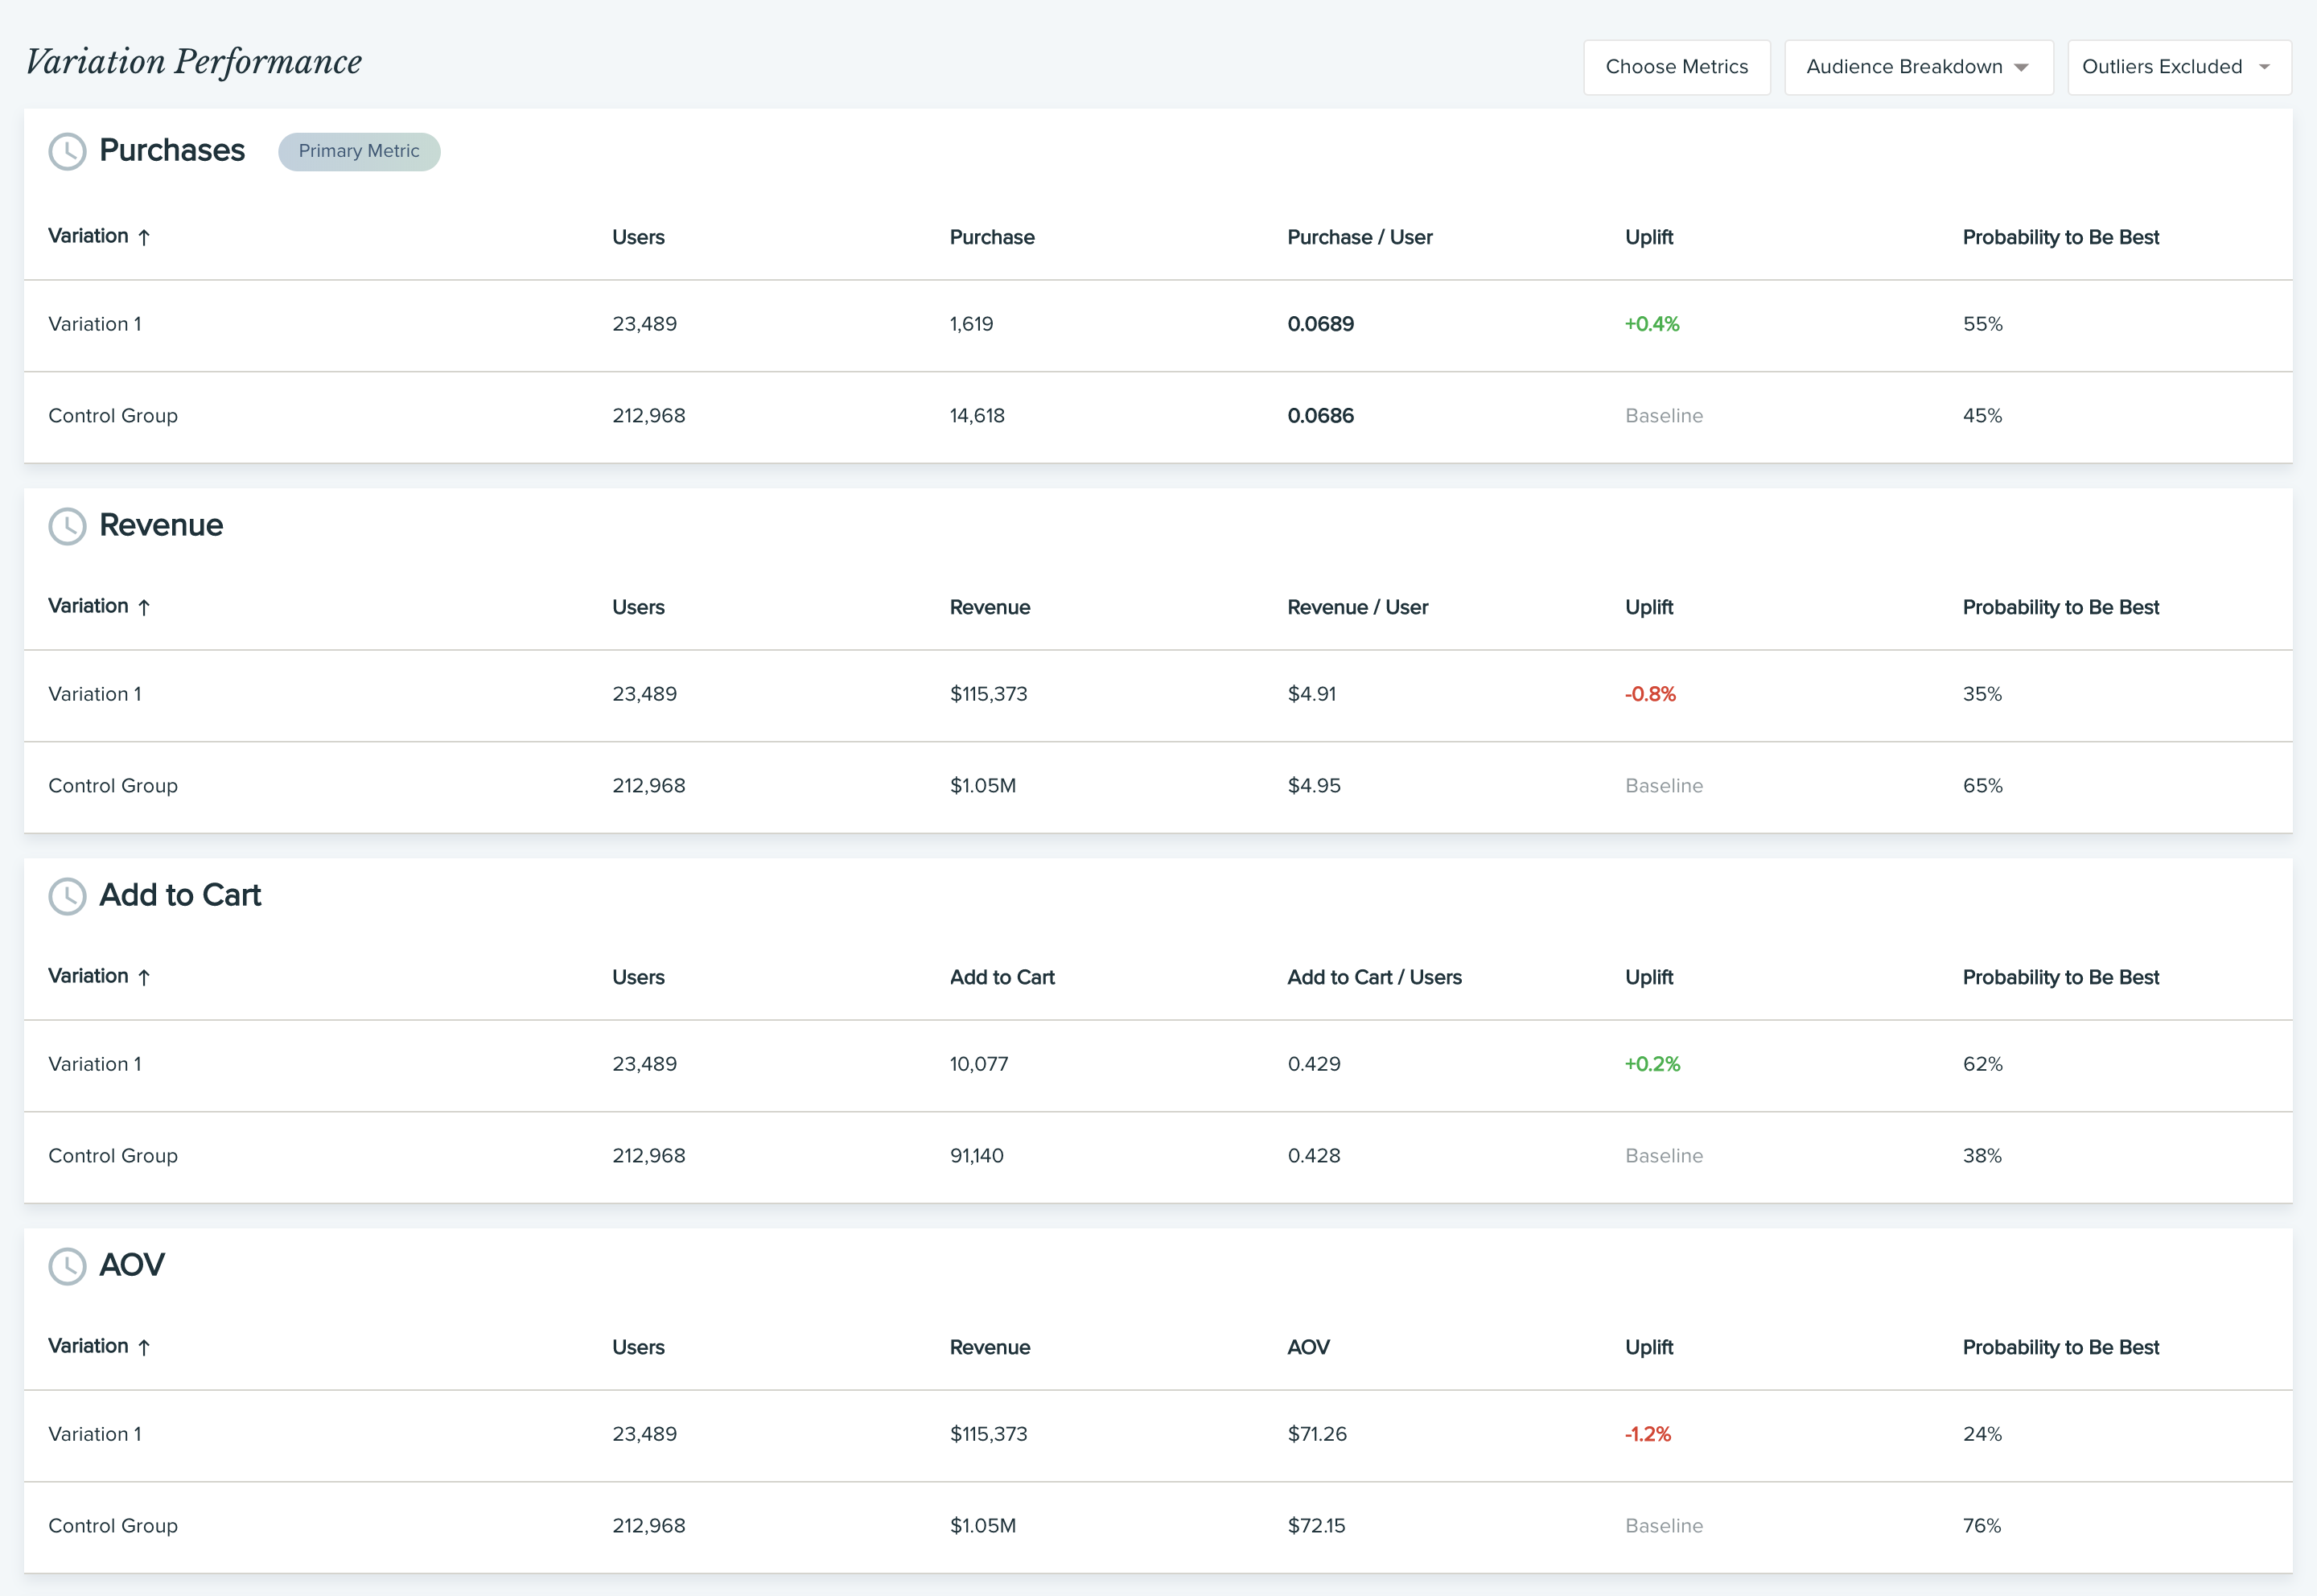
Även om vinnaren i varje test baseras på det primära mätvärdet mäter vissa experimentplattformar som Dynamic Yield även ytterligare mätvärden som kallas sekundära mätvärden. Vi rekommenderar att du analyserar sekundära mätvärden innan du avslutar experimentet och tillämpar den vinnande varianten för alla användare av några anledningar:
För varje sekundärt mätvärde föreslår vi att du tittar på lyftet (uplift) och sannolikheten för att vara bäst (Probability to Be Best) för att se hur varje variation presterade.
Efter din analys kan du avgöra om du vill skicka all din trafik till den vinnande varianten, eller justera fördelningen utifrån det du har lärt dig.
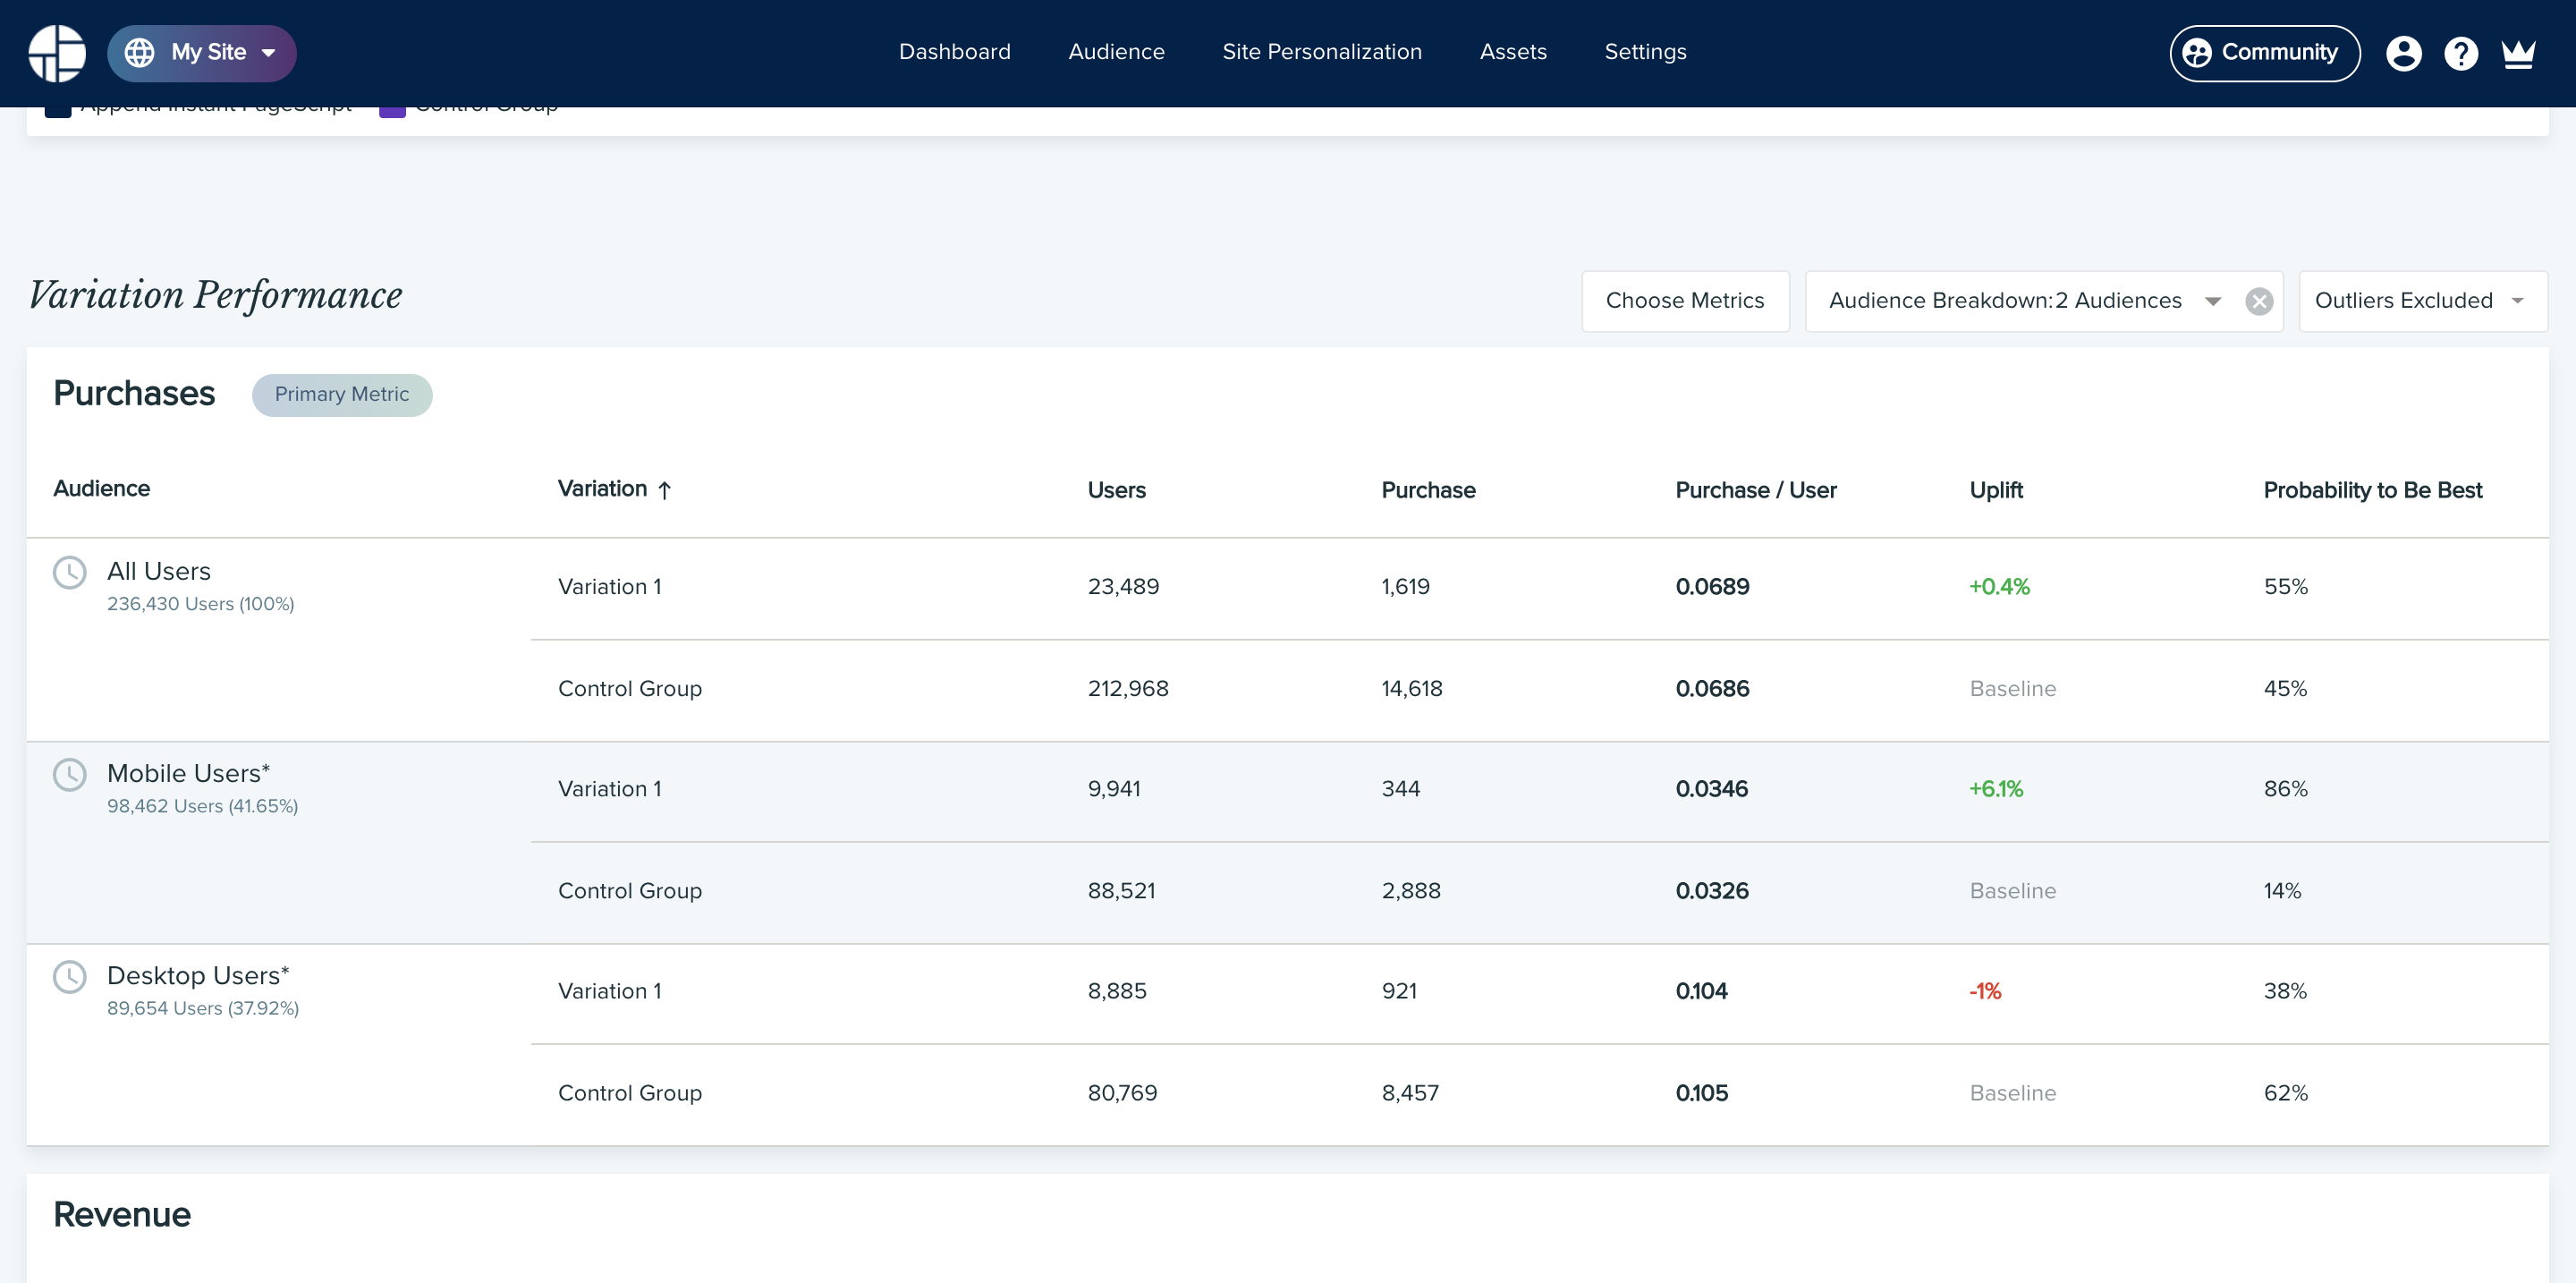
Ett annat bra sätt att gräva djupare är att dela upp dina resultat efter målgrupp. Detta kan hjälpa till att besvara frågor som:
Jag rekommenderar att du väljer målgrupper som är relevanta för din verksamhet, samt målgrupper som sannolikt har olika användarbeteenden och avsiktssignaler.
Titta än en gång på förbättringen och sannolikhetsvärdena (Probability to Be Best) för varje målgrupp för att se hur respektive variant presterade. Efter din analys kan du avgöra om du ska skicka all din trafik till den vinnande varianten eller justera fördelningen utifrån vad du har lärt dig.
Det råder ingen tvekan om att CRO och A/B-testning fungerar, något som länge har litats på för att ge enorma ökningar av konvertering och intäkter för dem som på ett korrekt sätt identifierar den bästa möjliga variationen för webbplatsbesökare. Sanningen är dock att i takt med att leverans av personaliserade interaktioner Become en mer integrerad del av kundupplevelsen, kommer experiment som inte tar hänsyn till enskilda målgruppers unika förutsättningar att leda till icke-konklusiva resultat och statistisk signifikans Become svårare att uppnå.
I denna komplexa nya värld av personalisering där en-till-en-kommunikation ersätter ett en-till-många-angreppssätt kan ”genomsnittsanvändare” inte längre tala för ”alla besökare”. Det innebär att tidigare metoder för att identifiera och leverera de bästa upplevelserna inte längre räcker, trots att bästa praxis för att skapa urvalsstorlek, utveckla hypoteser och optimera KPI:er följs.
I stället för att acceptera testresultat till det yttre och implementera variationer som förväntas prestera bäst totalt sett för alla användare måste marknadsförare i dag förstå att de på så sätt kompromissar med upplevelsen för en annan del av besökarna. Eftersom det alltid kommer att finnas besökssegment för vilka den vinnande variationen inte är optimal. Först när man inser denna brist i testanalysen och genomförandet blir det tydligt att förlorade A/B-tester faktiskt kan visa sig bli vinnare, och att dolda möjligheter som en gång ansågs meningslösa faktiskt kan bära den största frukten genom ett moderniserat och personligt synsätt.
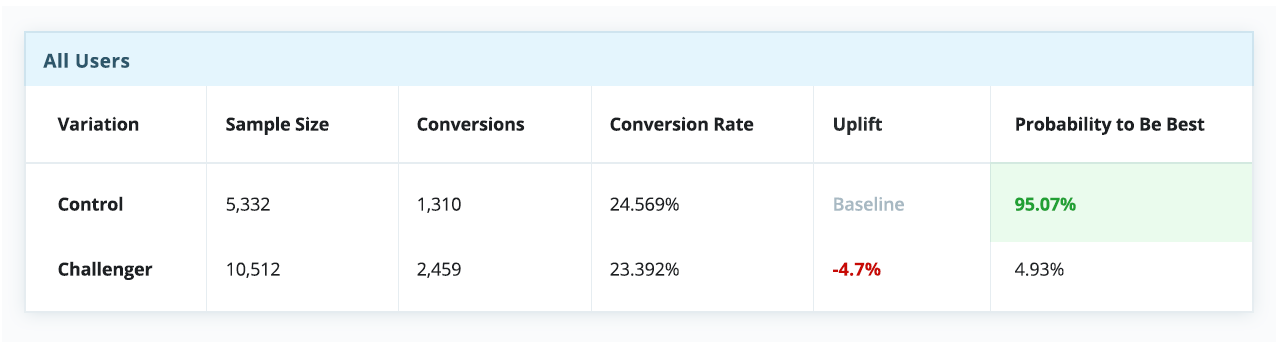
I exemplet nedan hittar du verkliga resultat från ett experiment som var igång i ungefär 30 dagar. Vid en första anblick, när det står nästan oavgjort, verkar det som om kontrollgruppen presterar bättre än utmanaren.
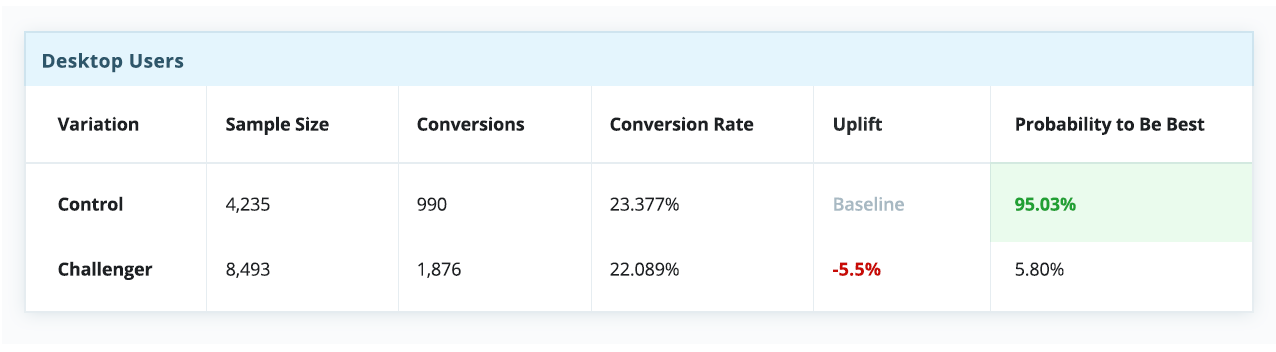
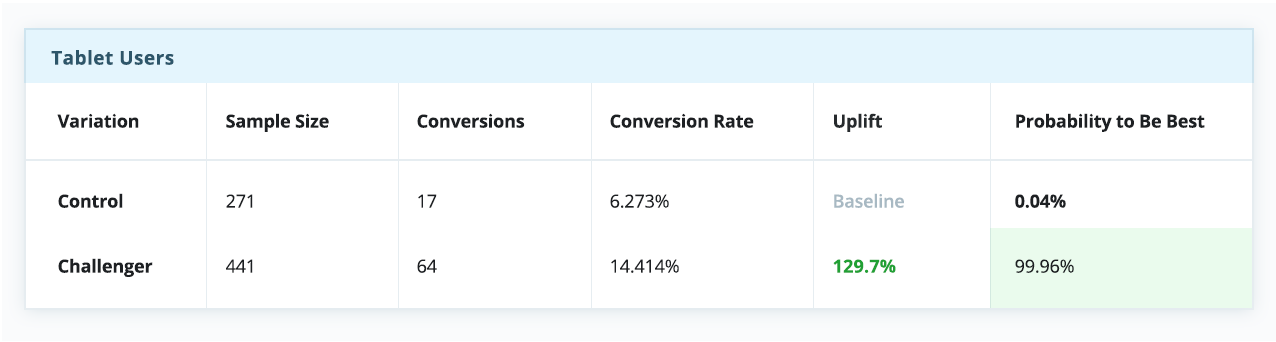
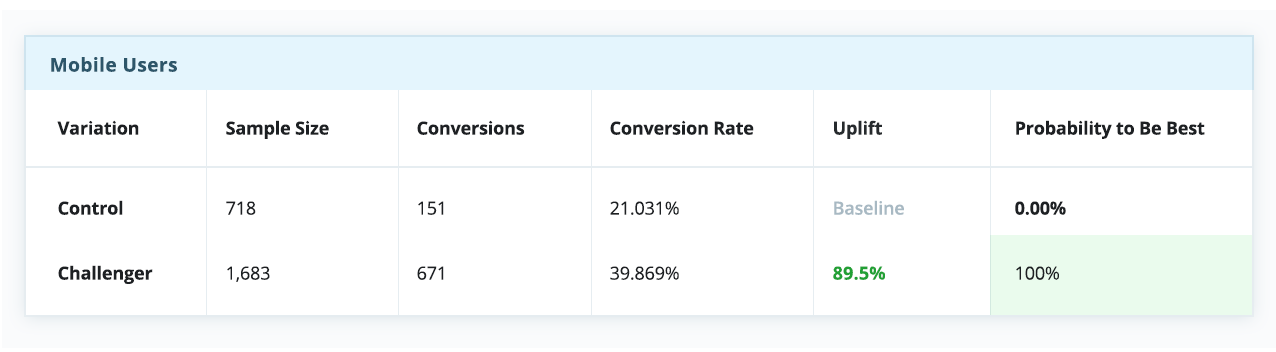
However, when breaking down the experiment report by devices, a relatively basic and straightforward measure, there’s a completely different story, indicating the control is a winner on desktop, but is dramatically outperformed by the challenger on both tablet and mobile.
I testscenariot ovan skulle hela besökargruppen – om en strategi med ”vinnaren tar allt” hade tillämpats (vilket många troget gör) – ovetande ha fått en kompromissad upplevelse som är ”optimerad” för en genomsnittlig användare, trots en tydlig preferens för utmanaren i mobilwebben och på surfplattor.
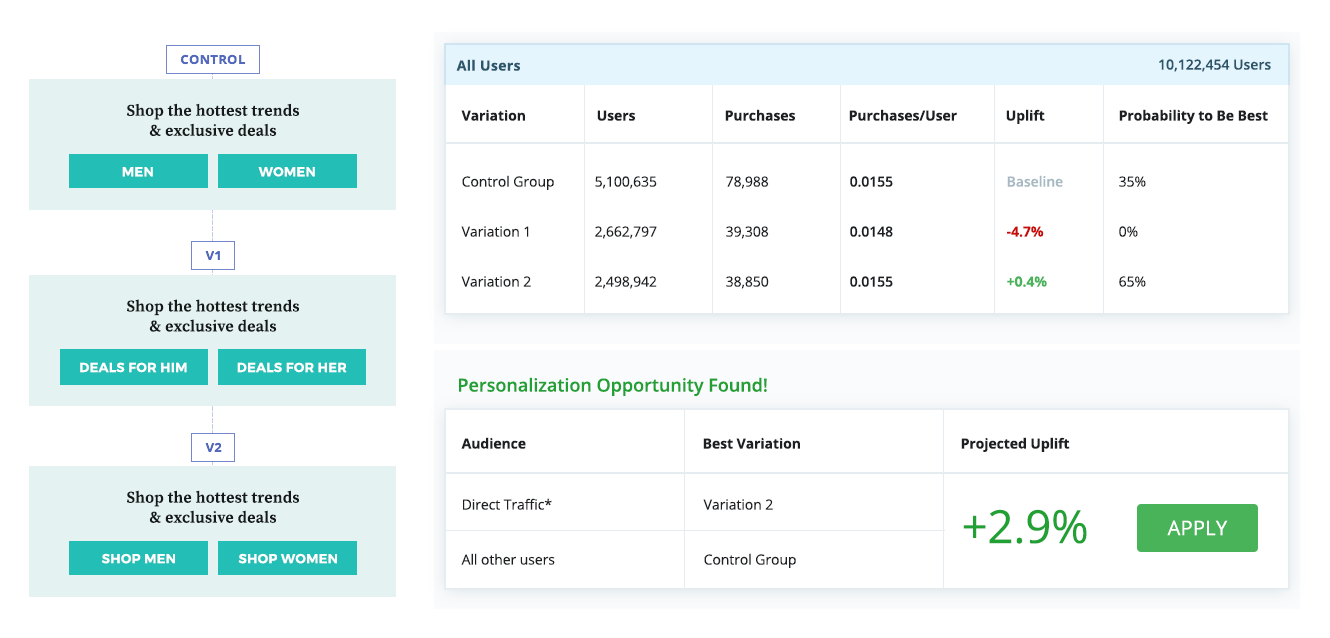
Ett annat exempel är att även om kontrollgruppen i genomsnitt presterar under genomsnittet, drar ytterligare analys slutsatsen att den faktiskt fortfarande bör tilldelas ”Alla andra användare”, vilket gör att det mycket större segmentet ”Direkt trafiken” får sin preferens, variant två.
Dessa referenser illustrerar hur viktigt det är att upptäcka effekten av teståtgärder på olika målgrupper när man kör experiment, oavsett hur segmentet definieras. Det är först när man tar sig tid att noggrant analysera resultaten av sina experiment för olika segment som djupare optimeringsmöjligheter kan identifieras, även för tester som inte ger några uppskjutningar för genomsnittsanvändaren (som egentligen inte existerar).
Även om vissa av dessa scenarier inte kräver mer än en snabb analys av en CRO-specialist, så hinns det inte alltid med att avsätta tid för det på grund av fullbokade testcykler och ständigt föränderliga prioriteringar. Det här problemet blir bara värre i takt med att antalet tester, variationer och segment ökar, vilket gör analysen till en otroligt datatung uppgift.
Med denna kunskap i åtanke, hur kan man gå tillbaka till ett liv där man accepterar status quo, tar resultat för givet och i onödan kastar bort behandlingar?