Lärdom

Bortom A/B-testning: Multi-armed bandit-experiment

Läs om hur algoritmer med flerarmade banditproblem (multi-armed bandit) avslutar experiment tidigare än det klassiska A/B-testet samtidigt som de gör färre statistiska fel på vägen.

Yaniv Navot profile photo

Yaniv Navot

Senior Vice President, Commercialization,

Consumer Acquisition & Engagement,

Mastercard

Under de senaste decennierna har vår förmåga att integrera, analysera och agera på datainsikter förbättrats avsevärt. Konverteringsoptimering är fortfarande en nyckelkomponent i digitala strategier, och A/B-testning samt experiment har become en nödvändig metod för företag som vill växa sin affär och förbättra resultatet.

Traditionally, companies have ran randomized A/B tests with just two variants (the baseline/control and treatment), looking to find a single statistically significant winner. Over time, rather than limiting the experiment to just two variations, marketers have started layering in additional segments, ensuring they are getting the most out of their experiments.

Även om många företag i dag regelbundet utför kontrollerade experiment är det dock många som inte är nöjda med resultaten och den tid det tar för att nå giltiga resultat. När trycket ökar på att leverera förbättrade resultat genom webbplatsoptimering och testning tänjer marknadsförare ständigt på gränserna för befintliga metoder.

För att förstå begränsningarna och till och med överskrida dem kommer jag att undersöka hur traditionell A/B-testning fungerar och hur både vetenskap och teknik har breddat omfattningen av optimeringsmöjligheterna. 

Omprövning av grundläggande testmetodik

För de flesta företag i dag är det vanligt förekommande att utföra A/B/n-testning vid sidan av dess multivariata motsvarighet. Under ganska lång tid har dessa metoder varit de enda tillgängliga tillvägagångssätten för att utföra testning på webbplatser, även om det finns många begränsningar.

Även om dessa metoder till exempel erbjuder en viss flexibilitet vid testning är de starkt beroende av att man hittar en enda bäst presterande (”vinnande”) variant. Marknadsförare utmanar nu status quo genom att ställa frågan:

  1. Varför måste vi vänta på tillräcklig urvalsstorlek och hög statistisk signifikans, för att sedan manuellt stoppa experimentet i stället för att ha en mekanism som smidigt och automatiskt kan konvergera mot den bäst presterande varianten?

  2. Hur kan vi automatiskt utnyttja vår enorma mängd datainsikter för att få förbättrade och optimerade resultat?

  3. Hur kan vi hjälpa våra organisationer att leva upp till de ökade kundförväntningarna på mycket relevant innehåll?

  4. Varför måste vi nöja oss med en enda ”vinnande” innehållsvvariation när vi borde kunna erbjuda flera skräddarsydda varianter baserat på preferenser och realtidskontext?

  5. Varför köra experiment för att maximera målkonverteringar i stället för att direkt maximera onlineintäkterna?

  6. Hur kan vi rent tekniskt minska de operativa kostnaderna och administrationskostnaderna och uppnå en kraftfull skalbarhet, agilitet och hastighet?

Det här är inte enkla frågor att besvara. Men efter att ha arbetat sig igenom dem inser många att klassiska testmetoder helt enkelt inte kan erbjuda en lösning.

Bandit-strategin

En multi-armed bandit

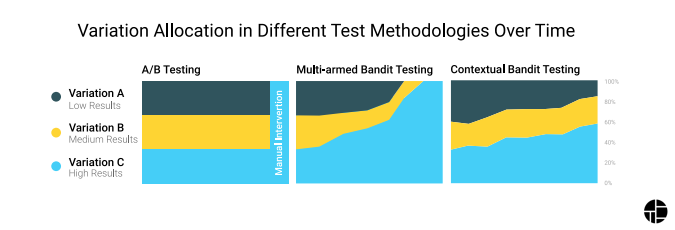
I traditionella A/B-testmetodiker delas trafiken jämnt mellan två varianter (båda får 50 %). Multi-armed bandits gör det möjligt att dynamiskt fördela trafik till varianter som presterar bra, samtidigt som mindre och mindre trafik tilldelas varianter som presterar sämre. Multi-armed bandits är kända för att ge snabbare resultat eftersom det inte finns något behov av att vänta på en enda vinnande variant.

Bandit-algoritmer går längre än klassisk A/B/n-testning genom att utnyttja ett stort antal algoritmer för att tackla olika problem – allt i syfte att uppnå bästa möjliga resultat. Med hjälp av ett relevant flöde av datainsikter kan multi-armed bandits become kontextbaserade. Kontextuella bandit-algoritmer förlitar sig på ett inkommande flöde av kontextuella fynd, antingen historiska eller färska, som kan användas för att fatta bättre algoritmbaserade beslut i realtid.

Nedan visas en visualisering av hur det klassiska A/B/n-testet skulle dela upp trafiken mellan flera varianter (tre i det här fallet) jämfört med testmetoderna multi-armed bandit och kontextuell bandit.

Grafer över variationsallokering i olika testmetodiker över tid.

Denna visualisering visar hur bandit-tester kan ge bättre resultat över tid. Medan det klassiska tillvägagångssättet kräver manuella ingrepp när en statistiskt säkerställd vinnare har hittats, lär sig bandit-algoritmer medan du testar, vilket säkerställer dynamisk trafikfördelning för varje variant.

Kontextuella banditalgoritmer ändrar den population som exponeras för varje variant för att maximera variantens prestanda, så det finns ingen enskild vinnande variant. På samma sätt finns det inte ens en enskild förlorande variant.

Grunden för allt detta är tanken att varje person kan reagera olika på olika innehåll. Till exempel skulle ett klassiskt A/B-test av kampanjinnehåll från en modesajt med 80 % kvinnliga kunder dra slutsatsen att det mest framgångsrika innehållet är kampanjer anpassade för kvinnor, trots att 20 % av kunderna förväntar sig kampanjer riktade till män.

I många fall representerar banditalgoritmer ett nytt tillvägagångssätt för att uppnå hållbart värde snabbare och mer effektivt. Med tanke på begränsningarna med traditionell A/B/n-testning erbjuder det ett nytt sätt att genomföra segmenterade experiment.

Detta tillvägagångssätt gör det i synnerhet möjligt för marknadsförare att:

  1. Leverera den bäst presterande variationen dynamiskt på användarnivå, vilket säkerställer att varje kund ser den bäst presterande, personliga innehållsvariationen i stället för en generisk vinnare som passar alla (och därför är missvisande)

  2. Optimera experiment direkt för maximal intäktsbaserad prestanda

  3. Gå från ett statiskt A/B/n-tillvägagångssätt till en flexibel plattform som automatiskt kan finjustera varje element för att maximera värdet

  4. Få full kontroll över alla datainsikter i realtid, vilket möjliggör bättre och mer effektiva datainsiktsdrivna beslut.

  5. Kör komplicerade optimeringsinitiativ med minimalt behov av it, även när du sätter upp komplexa experiment i ständigt föränderliga dynamiska miljöer.

Med rätt uppsättning verktyg och testmodeller kan marknadsförare dra nytta av kraften i sina datainsikter, från historiska rön till engagemangsmönster på webbplatsen, vilket i slutändan leder till framgångsrikare optimeringsinitiativ.

Kontakta säljavdelningen

Prata med en expert för att ta reda på hur Mastercard kan göra din verksamhet ännu bättre med hjälp av våra produkter och tjänster.

Mastercard