Branschen rör sig mot det bayesianska ramverket eftersom det är en enklare, mindre restriktiv, mer tillförlitlig och mer intuitiv metod för A/B-testning.
Tiden då marknadsförare gjorde ändringar på sina webbplatser enbart baserat på magkänsla ligger långt bakom oss. Vi befinner oss nu mitt i eran av A/B-testning och baserar våra beslut på så mycket empirisk data som möjligt.
För att möjliggöra detta har communityn letat efter verktyg för A/B-testning som hjälper oss att fatta välgrundade beslut baserat på insamlad data. Eller mer exakt uttryckt: att på ett tillförlitligt sätt generalisera utifrån observerad data och få insikter om framtiden.
Syftet med det här inlägget är att diskutera den utveckling som dessa verktyg för närvarande genomgår, från den grundläggande ”frequentist”-testmetoden som användes förr (och fortfarande är vanlig i dag) till den nya bayesianska testmetoden som branschen är på väg mot.
Under dessa två tillvägagångssätt ligger en annan syn på vad sannolikhet är. Jag kommer att försöka belysa den skillnaden och dess praktiska konsekvenser, men utan att fördjupa mig i den tunga matematiken.
I början av A/B-testningens era tillhandahöll statistiker ett mycket enkelt ramverk för statistisk slutledning i ett A/B-testscenario. Förfarandet, som allmänt kallas ”hypotesprövning”, går till på följande sätt:
Folk brukar tro att p-värdet representerar sannolikheten för att variation B verkligen är bättre än A. Detta är dock en vanlig felstolkning; det har egentligen att göra med den hypotes som ligger till grund för hypotesprövning.
Det p-värdet testar för är inte det ”optimistiska” fallet där vår alternativa variation B faktiskt är bättre än baslinjen. I stället börjar vi med en pessimistisk hypotes (kallad ”nollhypotesen”) som anger att den nyligen introducerade variationen B inte är det minsta bättre än den befintliga baslinjen A, och att de observerade skillnaderna enbart utgör slumpmässigt brus.
Vi försöker sedan förkasta denna hypotes genom att beräkna hur sällsynta våra empiriska fynd är om ovanstående nollhypotes stämmer. P-värdet representerar den sannolikheten.
Om p-värdet är under ett visst tröskelvärde (ofta 0,05) kan vi konstatera att vårt resultat gör att vi kan förkasta nollhypotesen och därmed utse variant B till vinnare. Dessutom erbjuder detta ramverk för hypotesprövning ett sätt att beräkna ett konfidensintervall, vilket syftar till att ge en uppfattning om hur säkra vi är på att de uppmätta värdena kommer att bestå på lång sikt.
Ta en stund och lägg märke till hur invecklat och ointuitivt detta ramverk är.
Det kräver en känd baslinje och att vi når en fördefinierad urvalsstorlek innan vi tillåts titta på data och dra slutsatser. Dessa slutsatser baseras på mätvärden som, för att parafrasera Inigo Montoya i ”Prinsessans brud”, inte betyder det som de flesta tror att de betyder.
Det väcker frågan: kan vi göra något för att göra det enklare, mindre restriktivt, mer tillförlitligt och mer intuitivt? Svaret är ja.
Inom området statistisk inferens finns det två mycket olika, men ändå etablerade tankeskolor: det frekventistiska tillvägagångssättet, under vilket ramverket för hypotesprövning utvecklades, och det bayesianska tillvägagångssättet som jag nu vill introducera för dig.
Skillnaden mellan dessa två rivaliserande skolor kan förklaras genom den olika tolknig som var och en ger begreppet sannolikhet. Introduktionen som ges här är anpassad från denna serie blogginlägg.
Låt oss ta ett konkret exempel: antag att vi är intresserade av att ta reda på den genomsnittliga längden på amerikanska medborgare nuförtiden. För en frekventist är detta tal okänt men fast. Detta är en naturligt intuitiv synvinkel, eftersom man kan föreställa sig att om man går igenom alla amerikanska medborgare en i taget, mäter deras längd och beräknar ett genomsnitt av listan, så får man det faktiska talet.
Eftersom du dock inte har tillgång till alla amerikanska medborgare tar du ett urval på till exempel tusen medborgare, mäter och beräknar medelvärdet för deras längd för att ta fram en punktskattning och beräknar sedan uppskattningen av felet. Poängen är att frekventisten betraktar medellängden som ett enskilt okänt tal.
En bayesiansk statistiker skulle dock se helt annorlunda på situationen. En bayesian skulle inte se en amerikansk medborgares medellängd som en fast siffra, utan snarare som en okänd fördelning (här kan man tänka sig en ”klockformad” normalfördelning).
Till en början har den bayerska statistikern viss grundläggande förkunskap som antas: till exempel att medellängden ligger någonstans mellan 50 cm och 250 cm.
Därefter börjar bayesianen mäta höjden på specifika amerikanska medborgare och uppdaterar med varje mätning fördelningen för att Become lite mer ”klockformad” kring den genomsnittliga höjd som uppmätts hittills. Allteftersom mer data samlas in blir ”klockan” skarpare och mer koncentrerad kring den uppmätta medellängden.
För bayesianer är sannolikheter i grunden kopplade till deras kunskap om en händelse. Detta innebär till exempel att vi ur ett bayesianskt perspektiv på ett meningsfullt sätt kan tala om sannolikheten för att den sanna konverteringsgraden ligger inom ett givet intervall, och att den sannolikheten kodifierar vår kunskap om värdet baserat på tidigare information och/eller tillgängliga data.
För bayesianer utökas sannolikhetsbegreppet till att omfatta grader av säkerhet kring ett visst påstående om verkligheten. I en strikt frekventistisk syn är det dock meningslöst att tala om sannolikheten för den sanna konverteringsgraden. För frekventister är den sanna konverteringsgraden per definition ett enskilt fast tal, och att tala om en sannolikhetsfördelning för ett fast tal är matematiskt orimligt.
Samma logik gäller när man vill mäta konverteringsgraden i en webbaserad köptratta. Sannolikheten kan naturligtvis uppskattas på ett frekventistiskt sätt genom att man mäter förhållandet mellan hur många gånger en konvertering gjordes i ett stort antal försök. Men detta är inte grundläggande för bayesianen, som kan stoppa testet när som helst och beräkna sannolikheter utifrån data.
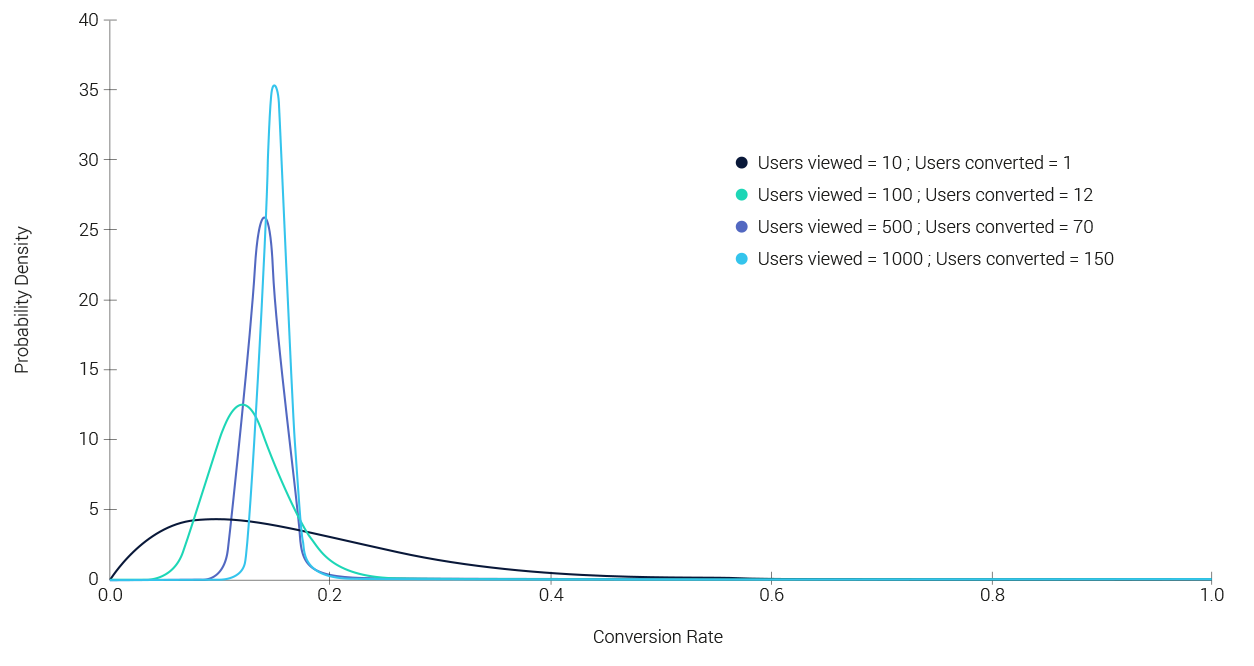
För att illustrera distributionskonvergensen när mer data samlas in följer här ett diagram som baseras på testdata. Lägg märke till hur klockkurvan blir skarpare (mer säker) när dataströmmar anländer:
Till en början har den bayerska statistikern viss grundläggande förkunskap som antas: till exempel att medellängden ligger någonstans mellan 50 cm och 250 cm.
Därefter börjar bayesianen mäta höjden på specifika amerikanska medborgare och uppdaterar med varje mätning fördelningen för att Become lite mer ”klockformad” kring den genomsnittliga höjd som uppmätts hittills. Allteftersom mer data samlas in blir ”klockan” skarpare och mer koncentrerad kring den uppmätta medellängden.
För bayesianer är sannolikheter i grunden kopplade till deras kunskap om en händelse. Detta innebär till exempel att vi ur ett bayesianskt perspektiv på ett meningsfullt sätt kan tala om sannolikheten för att den sanna konverteringsgraden ligger inom ett givet intervall, och att den sannolikheten kodifierar vår kunskap om värdet baserat på tidigare information och/eller tillgängliga data.
För bayesianer utökas sannolikhetsbegreppet till att omfatta grader av säkerhet kring ett visst påstående om verkligheten. I en strikt frekventistisk syn är det dock meningslöst att tala om sannolikheten för den sanna konverteringsgraden. För frekventister är den sanna konverteringsgraden per definition ett enskilt fast tal, och att tala om en sannolikhetsfördelning för ett fast tal är matematiskt orimligt.
Samma logik gäller när man vill mäta konverteringsgraden i en webbaserad köptratta. Sannolikheten kan naturligtvis uppskattas på ett frekventistiskt sätt genom att man mäter förhållandet mellan hur många gånger en konvertering gjordes i ett stort antal försök. Men detta är inte grundläggande för bayesianen, som kan stoppa testet när som helst och beräkna sannolikheter utifrån data.
För att illustrera distributionskonvergensen när mer data samlas in följer här ett diagram som baseras på testdata. Lägg märke till hur klockkurvan blir skarpare (mer säker) när dataströmmar anländer:
Matematiken bakom det Bayesianska ramverket är ganska komplex så jag går inte in på det här. Faktum är att jag skulle vilja hävda att det faktum att matematiken är mer komplicerad än vad som kan beräknas med en enkel räknare eller Microsoft Excel är en bidragande orsak till att denna metod har tagits i bruk så långsamt inom branschen.
Ramverket omfattar en del avskräckande termer som prioriterad, posterior, Bayes sats, beta- och gammafördelning, Monte Carlo-integrering med mera.
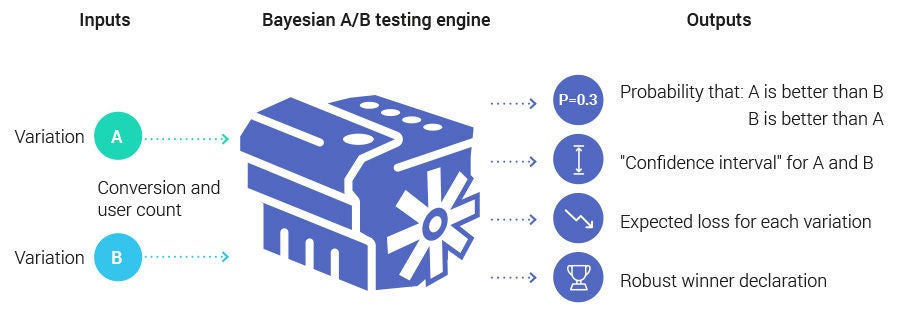
Om vi däremot betraktar den bayerska statistiska motorn som en ”matematisk svart låda” ser vi att indata till den, och ännu viktigare utdata från den, faktiskt är ganska enkla och intuitiva. Ett in-/utdatadiagram över motorn skulle se ut ungefär så här:
Även om vi inte går in på detaljer kan du omedelbart se att den bayerska motorn ger svar på mer direkta frågor som:
Vad är sannolikheten för att A är bättre än B? (jämför detta med det konstlade p-värdet som nämndes tidigare)
Om jag utser B till vinnare och den inte är nämnvärt bättre, hur mycket kan jag förvänta mig att förlora i konverteringsgrad?
Denna motor kan dessutom generera en ny typ av ”konfidensintervall”-mått, som matematiskt kallas för Highest Posterior Density Region (HPDR). Detta ger ett svar på ett ganska intuitivt krav, nämligen: ge mig de gränser (intervall) för konverteringsgraden inom vilka den sanna konverteringsgraden hamnar med (säg) 95 % sannolikhet.
Om vi vill vara exakta med innebörden av det ofta använda frekventistiska konfidensintervallet betyder det ungefär följande: ”Om vi hade upprepat det här testet många gånger och hade beräknat ett annat konfidensintervall för varje fall, skulle den faktiska konverteringsgraden hamna inom detta intervall 95 % av gångerna.” Vad tycks om den intuitiviteten?
Låt oss sammanfatta hur de två ramverken skiljer sig åt:
| Hypotesprövning | Bayesiansk A/B-testning | |
| Kunskap om baslinjeprestanda | Obligatoriskt | Krävs inte |
| Intuitivitet | Färre, eftersom p-värde är en krånglig term | Mer, eftersom vi direkt beräknar sannolikheten för att A är bättre än B |
| Urvalsstorlek | Fördefinierad | Inget behov av att fördefiniera |
| Kontrollera data medan testet körs | Inte tillåtet | Tillåtet (med försiktighet) |
| Snabb på att fatta beslut | Mindre, eftersom den har mer restriktiva antaganden om fördelningar | Mer, eftersom den har mindre begränsande antaganden |
| Visar osäkerhet | Konfidensintervall (ett komplext uttryck som ofta missförstås) | Highest Posterior Density Region – mycket intuitiv tolkning |
| Utses till vinnare | När urvalsstorleken har uppnåtts och p-värdet ligger under ett visst tröskelvärde | När antingen ”sannolikhet att vara bäst” går över ett tröskelvärde eller den förväntade förlusten är under ett tröskelvärde (i vilket fall en ”oavgjord situation” kan förklaras mellan flera variationer) |
Jag bör dock påpeka att det generellt sett är möjligt med ett frekventistiskt A/B-testramverk som presterar lika bra som det bayesianska ramverket som beskrivs här, men att det skulle krävas ytterligare utveckling utöver det som vanligtvis implementeras.
Sammanfattningsvis rör sig branschen mot det bayesianska ramverket, eftersom det är ett enklare, mindre restriktivt, mer tillförlitligt och mer intuitivt tillvägagångssätt för A/B-testning.
P.S. Här på Dynamic Yield har vi gått över till en bayesiansk statistisk motor, inte bara för binära mål som konverteringsfrekvens och klickfrekvens (CTR), utan även för icke-binära mål som intäkt per användare (vilket är värt ett eget blogginlägg i framtiden). Med den här nya motorn drar våra kunder nu nytta av en snabbare och mer robust statistisk motor.