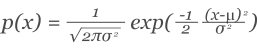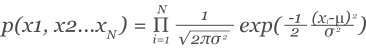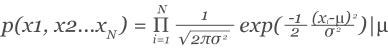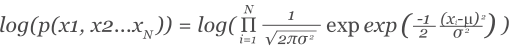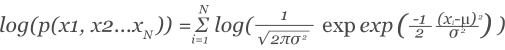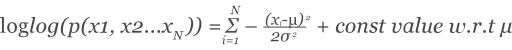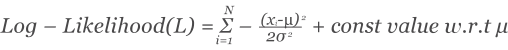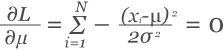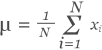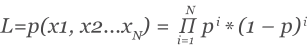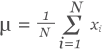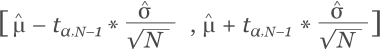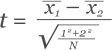Från idé till genomförande och analys kan data och analys stödja marknadsförare i alla lägen och förvandla vilket företag som helst till en insiktsdriven branschledare.
I experimenteringens barndom tillhandahöll statistiker ett mycket enkelt ramverk för statistisk inferens i scenarier med A/B-testning. Det frekventistiska angreppssättet, som fortfarande används flitigt i dag och inom vars ramar hypotesprövning utvecklades, gjorde det möjligt för branschen att ytterligare undersöka teorier om engagemang och fastställa om det finns tillräckligt med statistiska belägg för att stödja en specifik teori.
Senare skulle skillnader i hur man tolkar sannolikhet på det mest effektivaste sättet ge upphov till ett nytt bayesianskt tillvägagångssätt – en metod som många menar är mindre restriktiv, mycket intuitiv och mer tillförlitlig (en uppfattning som också delas av oss på Mastercard Dynamic Yield). I syfte med det här inlägget kommer jag att dyka ner i siffrorna bakom frekventisternas synsätt och utföra lämpliga härledningar där så behövs.
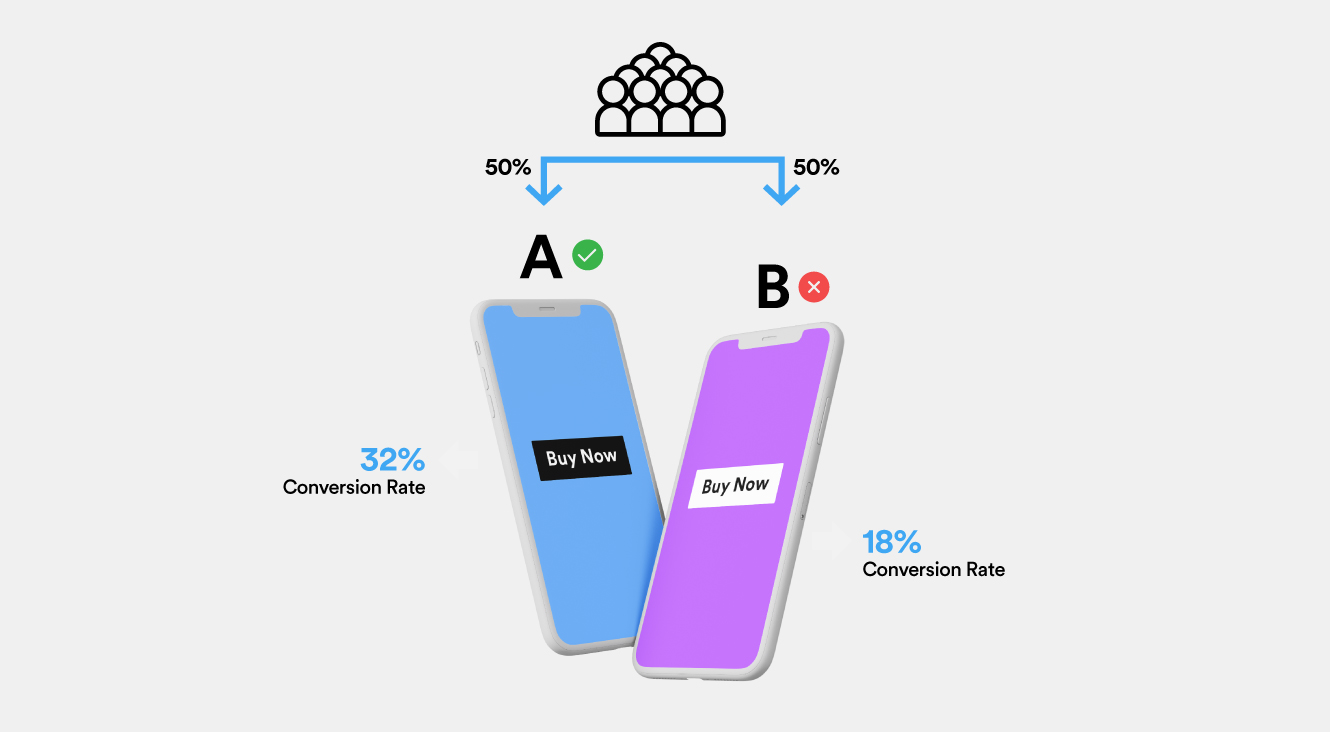
På en övergripande nivå börjar man vid en traditionell A/B-testning med en hypotes – ett förutsägande uttalande om effekten av en förändring. Därefter beräknas en urvalsstorlek för att uppnå statistisk signifikans (95 %), trafiken delas upp mellan variationerna, resultaten mäts och en slutsats dras, antingen för att validera eller misslyckas med att validera den ursprungliga hypotesen.
Att nå en hypotes görs vanligtvis efter en intern brainstormingsession eller upptäcks genom fokusgruppsundersökningar. Jag kommer att prata om beräkning av urvalsstorlek senare. Det tredje steget i processen, att mäta resultaten, är där det börjar bli komplicerat.
Om du var tvungen att komma fram till en klickfrekvens för varje variant, kan du visa varje variant för en enda användare, beräkna klickfrekvensen och dra slutsatsen om vilken variant som är bättre? Självklart inte!
Vi vet intuitivt att ett klick av 10 visningar inte är lika tillförlitligt som tio klick av 100, även om båda scenarierna har samma klickfrekvens. Om man drar ut på detta resonemang i ett idealt scenario måste man alltså köra the testet under oändlig tid, nå den sanna konverteringsgraden för båda varianterna och avsluta testet med 100 % konfidens.
Eftersom detta inte är ett alternativ arbetar vi med sannolikhetsfunktioner för att besvara frågan: Vilken klickfrekvens för en variation ligger närmast den ”sanna” klickfrekvensen?
När du först börjar samla in datainsikter från dina variationer är det normalt att siffrorna spretar åt alla håll. Så hur hittar man ett enskilt värde som representerar variationens konverteringsgrad? Genom att ta reda på urvalets medelvärdesuppskattning.
De datainsikter som samlas in under experimentet kan vanligtvis karaktäriseras av en underliggande fördelning. Till exempel Gaussfördelning/normalfördelning om du mäter längden på elever i en klass, eller Bernoulli-fördelning om du kartlägger en binär variabel som en myntkastning.
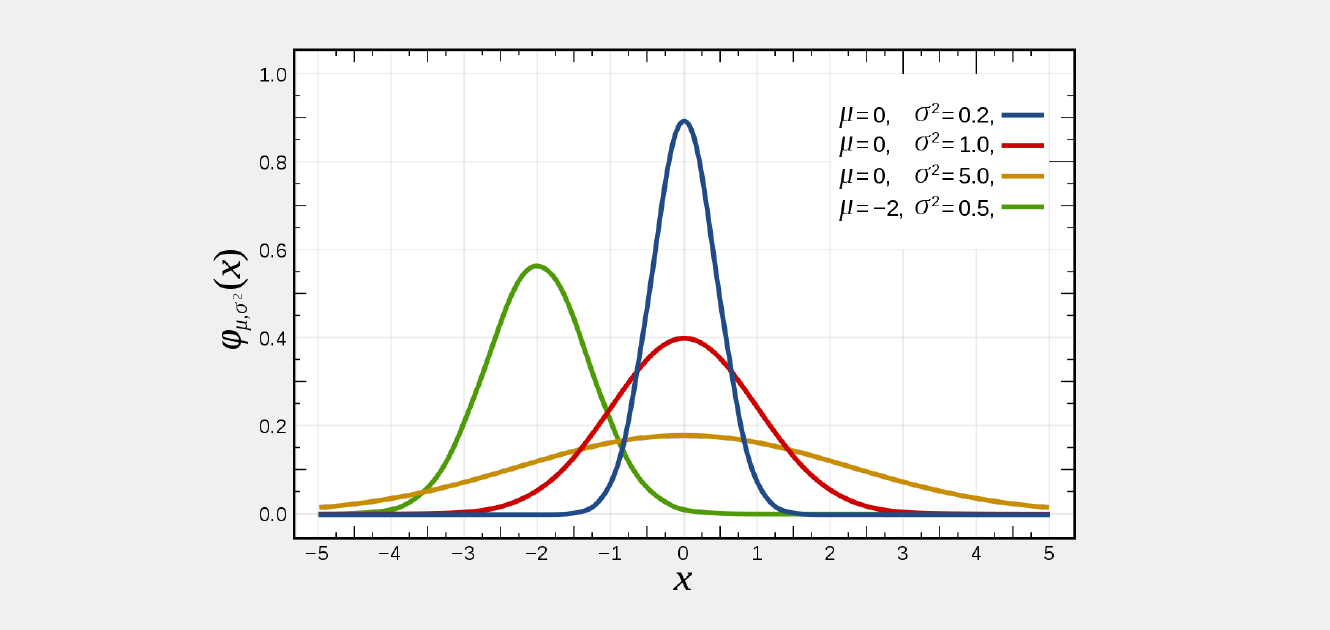
I vårt fall följer klickfrekvensen sannolikt en normalfördelning. Gaussfördelning definieras av två parametrar: medelvärde (μ) och varians ( ² ).
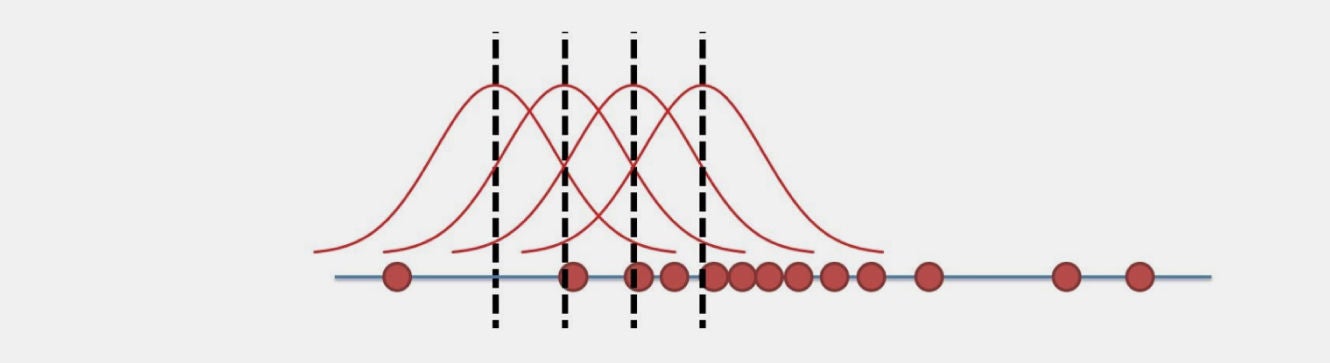
Ju bredare distributionen är, desto längre ifrån varandra ligger insikterna från stickprovsdata. Som ni ser kan det finnas många normalfördelningar med olika medelvärden som potentiellt kan representera de underliggande datainsikterna.
Men det finns bara en normalfördelning som maximerar sannolikheten för att observera det vi ser: maximum likelihood-metoden. Det medelvärde där denna ’maximum likelihood-skattning’ inträffar är det ’skattade stickprovsmedelvärde’ som vi är ute efter. Detta skattade stickprovsmedelvärde kommer att ligga närmast den ’ideala konverteringsgraden’ med utgångspunkt i de datainsikter som samlats in för en variant.
Låt oss gå tillbaka till grunderna och försöka härleda uppskattningen av stickprovsmedelvärdet. Om du inte är intresserad av härledningen kan du skrolla längst ned i det här avsnittet för att se slutformeln.
Jag arbetar med en Gaussfördelning först här. Senare kommer vi att göra samma sak för en Bernoulli.
Sannolikhetstäthetsfunktionen för en gaussfördelning är:
Om du har en normalfördelning med ett väntevärde och en varians och vill beräkna sannolikheten för att ett visst värde ’X’ ska inträffa, fyller du bara i ekvationen med värdet för X och får sannolikheten för det värdet.
Om vi drar ut på den här logiken och vill hitta den gemensamma sannolikheten för alla prover som samlats in i ett experiment kan vi – eftersom proverna är oberoende och likafördelade (IID) – helt enkelt multiplicera sannolikheterna för enskilda prover på följande sätt:
Den här sannolikhetsfunktionen besvarar huvudfrågan: Vad är sannolikheten att se dessa datainsikter givet medelvärdet μ?
Maximum likelihood-metoden maximerar värdet av sannolikhetsfunktionen och besvarar den mest kritiska frågan: Vilket värde på μ maximerar sannolikheten för de dataresurser som jag ser i proven?
Inom kalkylen, för att maximera en funktion med avseende på en variabel, hittar vi derivatan:
dp/dμ = 0, lösning med avseende på μ
Eftersom Gausskurvan är en exponentialfunktion blir derivatan återigen en exponentialfunktion. För att undvika detta tar vi logaritmen på båda sidor, vilket reducerar exponentialfunktionen till linjära värden (logaritmen är en monotont växande funktion, precis som exponentialfunktionen):
När vi nu tar the derivative of the log-likelihood med avseende på μ får vi:
Därför är uppskattningen av urvalsmedelvärdet:
Samma logik kan tillämpas för en Bernoulli.
Sannolikhetsfunktionen för en bernoullifördelning är:
Genom att följa en liknande process, ta logaritmen på båda sidor och derivera med avseende på p får vi väntevärdesskattningen för ett Bernoulliförsök som:
Där xi representerar antalet gånger händelserna inträffade / inte inträffade. Det innebär att uppskattningen av stickprovets medelvärde är likartad för både den gaussiska fördelningen och Bernoullifördelningen, och båda har ett mycket uppenbart problem.
Som har setts tidigare kokar urvalets medelvärdesskattning ner till:
Låt oss säga att du samlar in två klickfrekvenser. Till exempel 10,5 % och 9,5 %, och tillämpa formeln för att beräkna uppskattningen av urvalsmedelvärdet:
(10,5 + 9,5) / 2
Svarar det på hur säker du kan vara på din uppskattning vid 10 %? Kvantifierar den osäkerheten? Visar den hur nära eller långt ifrån du är att förstå den ”sanna” klickfrekvensen?
Vilket det uppenbarligen inte är, och det är därför vi arbetar med konfidensintervall och p-värden – så att vi kan kvantifiera osäkerheten kring de datainsikter som samlas in genom att inkludera antalet urval i ekvationen.
Efter att ha beräknat urvalets medelvärdesuppskattning ( ∧ ) kan vi med 95 % konfidensgrad dra slutsatsen att den ”sanna” klickfrekvensen ligger mellan:
Där tα = teststatistikan vid en konfidensnivå på 95 % och N–1 frihetsgrader (detta är ett färdigt förberäknat tal).
δ = urvalets standardavvikelse
N = stickprovsstorleken
Nu när vi har fastställt konfidensintervall kring våra datainsikter i ett test, hur utökar vi det till vår hypotesprövning och drar slutsatsen om vår hypotes är sann?
För att göra det:
1. Vi beräknar teststatistiken på följande sätt:
2. Koppla teststatistiken till ett p-värde
3. Förkasta hypotesen om värdet överstiger tröskelvärdet för P-kritiskt värde
Låt oss gå igenom varje steg för att förstå det bättre.
Steg ett: Ju större skillnad det är mellan variationernas skattade stickprovsmedelvärden, desto högre blir teststatistiken. Intuitivt sett gäller att ju större skillnad, desto tydligare framstår vinnaren. En tumregel är därför att det absoluta värdet för teststatistiken alltid bör vara högre.
Steg två: Teststatistikan är ett punktvärde på en normalfördelning som visar hur långt ifrån medelvärdet (i antal standardavvikelser) det ligger. För att omvandla punktuppskattningen till en sannolikhet behöver vi arean under kurvan, eller matematiskt uttryckt, den kumulativa fördelningsfunktionen. Vi kan integrera t-fördelningen eller Gaussfördelningen och ta reda på hur stor del av arean under kurvan som täcks av teststatistikan. Detta värde kallas p-värde. Som tur är har dessa nummer förberäknats och är offentligt tillgängliga, så vi behöver inte gå igenom alla detaljer.
Steg tre: När p-värdet väl är känt är det ganska enkelt att tolka det. Om det beräknade p-värdet är mindre än det P-tröskelvärde du har satt upp som gräns för att förkasta nollhypotesen, och om det är större än P-tröskelvärdet, misslyckas du med att förkasta nollhypotesen. Detta innebär inte att du accepterar att nollhypotesen är sann. Mer om detta senare.
Ett mycket invecklat mått som kan leda till stor förvirring: vår definition av p-värde är som följer:
Sannolikheten för att, när nollhypotesen är sann, det statistiska sammandraget (såsom skillnaden i stickprovets medelvärde mellan två grupper) skulle vara lika med eller mer extremt än de faktiskt observerade resultaten.
För att förklara: Låt oss säga att du börjar med en hypotes om att både kvinnor och män är lika långa. Du samlar in några datainsikter, beräknar medellängden för stickproven och finner 1,9 meter för män och 1,7 meter för kvinnor, med ett p-värde på 0,03. Detta p-värde ger dig sannolikheten för att du skulle se en skillnad (eller en större skillnad) i dina stickprov – om nollhypotesen vore sann. Med andra ord: om kvinnor och män faktiskt vore lika långa, är sannolikheten för att vi ska se en skillnad på 0,2 i medelvärdena mellan dem 3 %. Vi skulle därför förkasta hypotesen, eftersom detta är extremt sällsynt, och hävda att alternativet är sant. Det värde vid vilket du anser att sannolikheten är tillräckligt sällsynt är det kritiska p-värdet. Detta är vanligtvis 0,05 eller 0,01, vilket innebär att man accepterar att göra en felaktig slutsats 5 % av tiden.
Nu är det dags att prata om fel.
Om man försöker tolka en A/B-testsituation logiskt finns det rent teoretiskt två typer av fel:
Felaktigt förkasta en sann nollhypotes (typ I eller alfa) eller
Underlåta att förkasta en falsk nollhypotes (typ II eller beta)
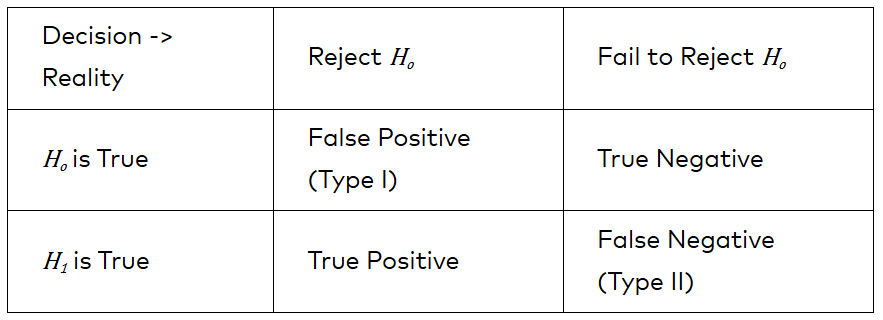
Tabellen nedan ger en bra översikt:
Det är enklare att se på fel i termer av falskt positiva och falskt negativa. Ett falskt positivt resultat innebär att du har identifierat en icke-existerande relation.
Hur kan något sådant hända?
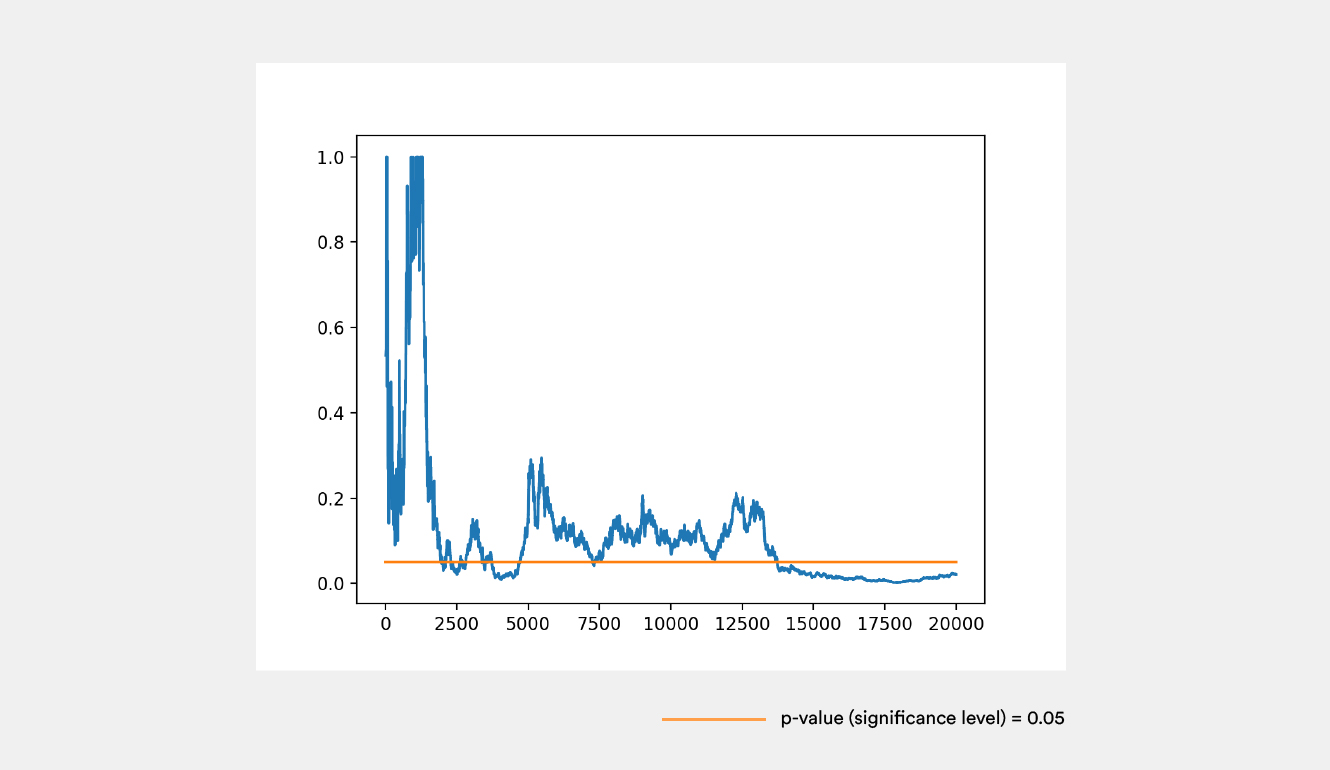
Låt säga att du startar ett A/B-test med ett p-värde på 0,01. Ett typiskt A/B-test har en progression för p-värde enligt följande:
Den blå linjen visar p-värdet och den gröna signifikansnivån. Som du kan ana vore det fel beslut att avsluta testet innan urvalsstorleken är tillräckligt stor, vilket skulle leda till att man försöker hitta bevis när det inte finns några. Det här är anledningen till varför det rekommenderas att inte tjuvkika på ett pågående A/B-test, eftersom det kan leda till felaktigt beslutsfattande baserat på olämpliga data.
Att uppnå signifikans är inte ”inkrementellt” av naturen vid traditionell A/B-testning. Du ser inte att resultaten förbättras gradvis över tid; du beräknar en urvalsstorlek, avstår från att tjuvkika tills den har nåtts och försöker sedan dra en slutsats när det beräknade urvalströskelvärdet har uppnåtts.
Om man inte gör det kan det bli extremt problematiskt. Oavsett om du kör en blixtförsäljning med begränsad tid för iterationer eller är ett medicinskt företag som försöker lösa en livshotande sjukdom, skulle du inte kunna avbryta ditt traditionella A/B-test eller din behandling halvvägs genom och börja bota människor. Du skulle behöva vänta tills testet var ordentligt slutfört av rädsla för att producera ett falskt positivt resultat.
När du kör ett traditionellt A/B-test där en variation presterar betydligt bättre än en annan visas fortfarande den förlorande variationen för en stor publik tills statistisk signifikans uppnås. Även om det gör det möjligt att utse en vinnare med säkerhet kan väntetiden leda till förlorade affärsmöjligheter.
I en ideal värld bör du kunna leda bort trafik från den sämre varianten och maximera intäkterna med vinnarvarianten. För att ge den sämre varianten en chans att ta ledningen tilldelar vi den en minimal procentsats av trafiken (kallad epsilon) och utnyttjar vinnarvarianten. Därmed har termen ”utforska vs. utnyttja” (även kallad ”epsilon-greedy” i vissa kretsar) uppstått, vilken handlar om hur mycket tid som ”slösas bort” på att lära sig i stället för att dra nytta av det som redan har lärts in. Den här funktionen är näst intill omöjlig i ett traditionellt A/B-test, såvida du inte är fast besluten om att producera falska positiva resultat.
Sammanfattningsvis av det som har tagits upp hittills:
Traditionell A/B-testning kan snabbt spåra ur med observationer som inkluderar en hög standardavvikelse på grund av obalanser i skalorna som lutar urvalets medelvärdesuppskattning.
En marginellt hög standardavvikelse i urvalspopulationen skulle kräva ett större antal urval för att nå acceptabla signifikansnivåer.
Att uppnå statistisk signifikans är per automatik inte ”stegvis” vid traditionell A/B-testning. Ett förhållningssätt utan tjuvtittar bör tillämpas tills ett test har slutförts.
Det finns alltid en risk för en ”falsk positiv” eller typ I-fel, i synnerhet om man stressar fram testet eller tittar på resultaten för tidigt.
En explore-exploit-strategi är inte möjlig, vilket gör att du går gli av pengar genom att fortsätta visa en variant som presterar sämre.
P-värdet är mycket svårtolkat och inte intuitivt.
Av alla dessa anledningar föredrar Mastercard Dynamic Yield den bayerska ansatsen för A/B-testning. Klicka här för att läsa mer om exakt hur det bayerska tillvägagångssättet övervinner några av de problem som vi har beskrivit ovan med traditionell A/B-testning.