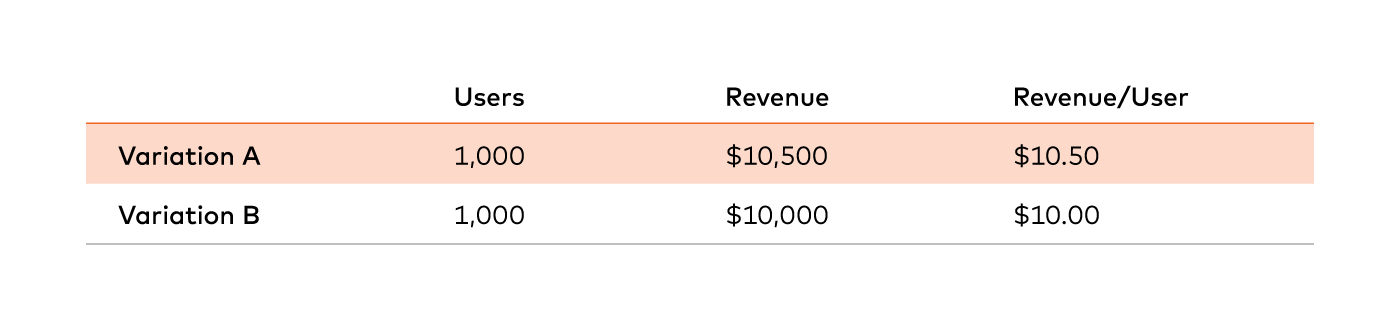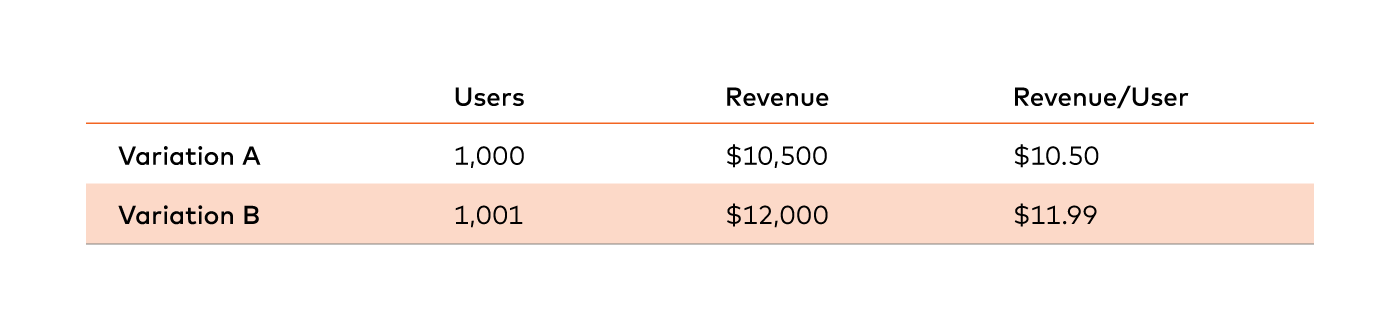Lektion

Identifiering av extremvärden vid A/B-testning

Stora avvikelser i webbplatsbeteendet kan leda till oavsiktliga konsekvenser i dina A/B-testkampanjer. Så här stämmer du av dem.

Gidi Vigo profile photo

Gidi Vigo

Vice President of Product,

Dynamic Yield,

Mastercard

När du kör ett A/B-test är en av de viktigaste frågorna vi vill besvara vilken variant som presterar bättre – inte bara under testet utan på sikt. Detta är anledningen till att vi tenderar att följa mätvärdet sannolikhet att vara bäst (P2BB). Till skillnad från mer ”naiva” beräkningar som uplift, vilka enbart jämför skillnader mellan resultaten för varje variant, försöker P2BB fastställa sannolikheten för att en ledande variant fortsätter att prestera bättre under en längre tidsperiod. Den tar de insamlade datainsikterna för varje variant och kör avancerade beräkningar för att generera ett poängtal. I praktiken används detta poängtal för att fastställa vinnare och förlorare, och fungerar vanligtvis som det yttersta beslutsunderlaget för om ett test ska avslutas och en vinnande variant tillämpas eller om man ska vänta på fler datainsikter. 

Men vad skulle hända om en enorm avvikelse i besökarnas engagemangsmönster en dag skulle bidra till en variants framgång, till exempel att en slumpmässig användare gör ett unikt köp? Baserat på det vi vet om P2BB kan man lugnt säga att denna typ av aktivitet kan leda till en falsk poängsumma som utnyttjar information som inte återspeglar normal webbplatsdynamik för att förutsäga framtida resultat av ett experiment. 

Därför måste de som ansvarar för upplevelseoptimering se till att ta hänsyn till och hantera dessa extrema händelser i sina kampanjer. Om man inte gör det snedvrids resultaten negativt till förmån för variationer som faktiskt kanske inte visar sig vara de bästa i slutändan. 

Ett beslut som du inte vill ska vila på dina axlar. 


Vad är avvikande värden?

Inom statistik avses med en observation värdet på en variabel som man är intresserad av att mäta under ett experiment eller ett test. Det kan finnas olika uppsättningar observationer som var och en har tilldelats ett eget värde i syfte att samla in datainsikter. 

Ett extremvärde är en observationspunkt som ligger långt från andra observationer. 

Exempelvis är medellängden för män i USA 176,5 cm. (1,77 m) men LeBron James, en NBA-spelare vars längd är 2,03 m, är ett undantag. Och inom e-handel kan ett undantag vara värdet av ett enskilt köp. 

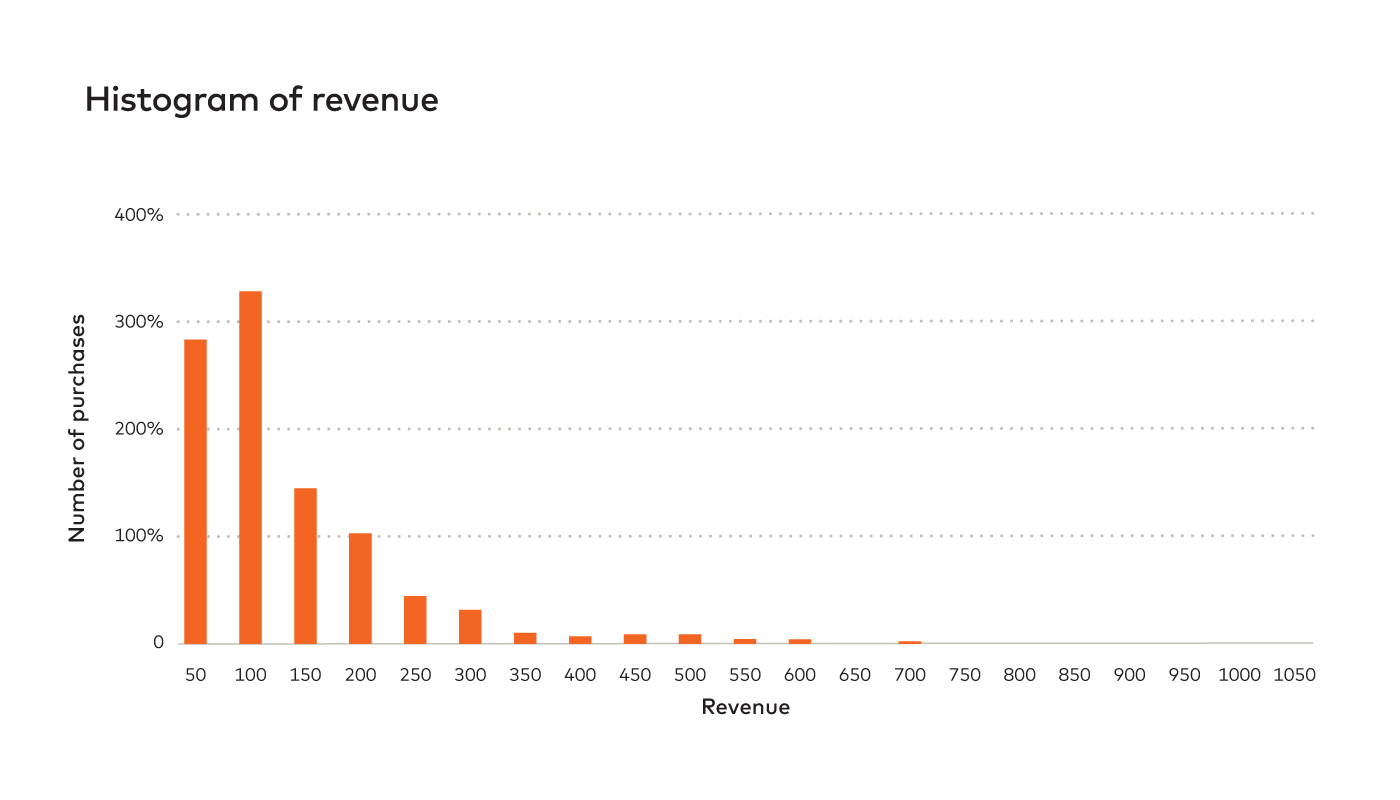
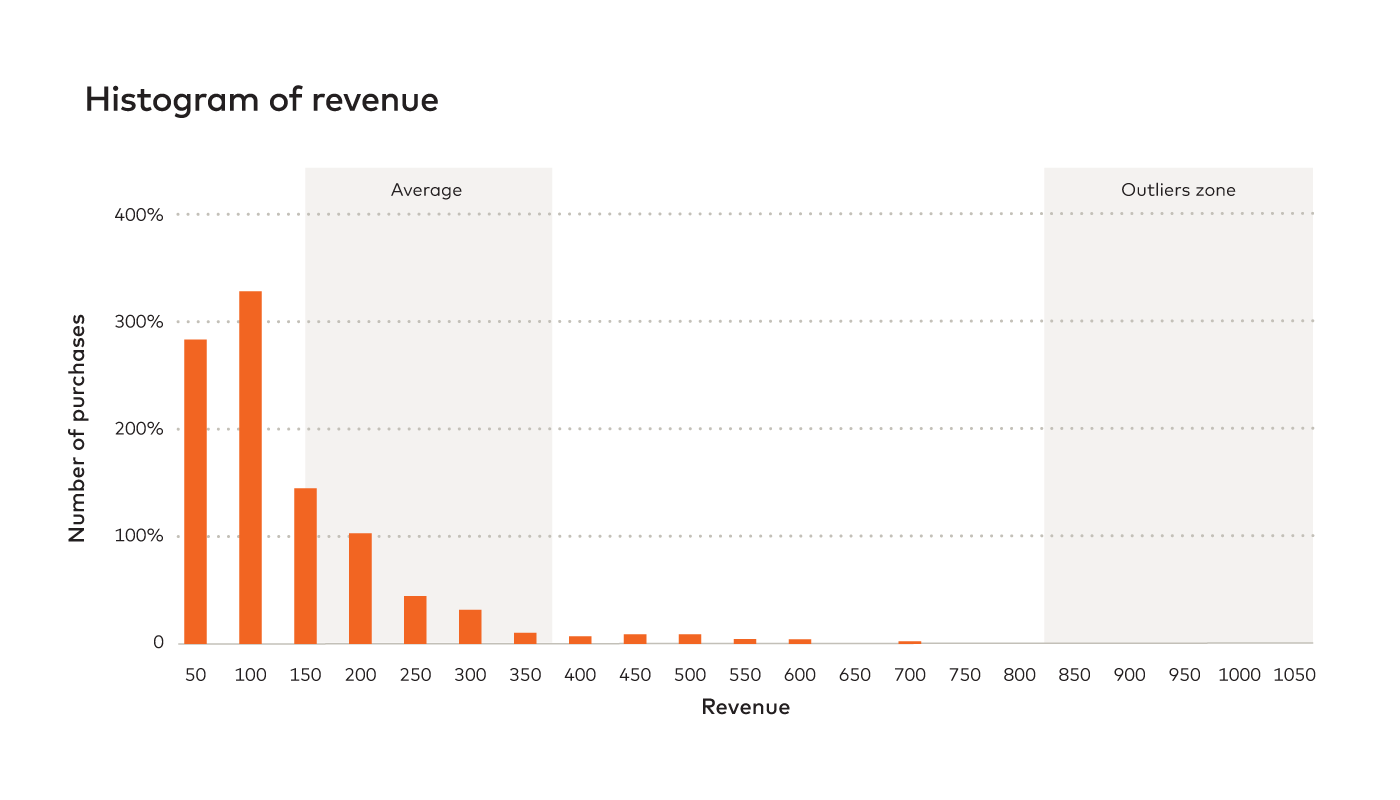
Nedan mäter vi ett urval av olika inköp som återspeglar olika intäktsvärden vid en viss tidpunkt. 

Histogram över intäkter

Av grafen att döma är de flesta angivna köpvärdena koncentrerade till intervallet 50–100 $, med flera köp som ligger närmare 1 000 $. Även om det rör sig om ett fåtal bör de betraktas som avvikande värden, eftersom de kan påverka slutsatser och handlingsförlopp för det aktuella A/B-testet. 

Vi tar en titt på hur ett irriterande avvikande värde kan leta sig in i dina testresultat. 

Följande visar ett experiment som inte påverkas av extremvärden, där variation A är den tydliga vinnaren efter att testet har visats för 2 000 användare. 

Varian A, konstnärlig bild

Om ett avvikande värde däremot dyker upp kan mätvärdena se helt annorlunda ut. Här har en individ plötsligt köpt 200 skjortor för 100 dollar styck och slumpmässigt fått variant B.

Bild för variant B

När man tittar på de råa datainsikterna förändrade en person med ett enda köp resultatet av ett test som visades för 2 000 användare helt. Det är extremt osannolikt att tester som denna person kan ha utsatts för (t.ex. knappfärg, rekommendationsstrategi) under den aktuella sessionen hade någon effekt på beslutet att spendera 20 000 $ på en större skjortbeställning på en gång. Att koppla detta köp till kampanjen skulle därför leda till antagandet att en variant som förlorade faktiskt var vinnaren. Vilket är anledningen till varför det är så avgörande att identifiera avvikande händelser när man analyserar A/B-tester för att få fram tillförlitliga resultat. 


Hur filtrerar man bort extremvärden? 

För det första måste det aktuella medelvärdet särskiljas. Utifrån det kan en standardavvikelse beräknas – detta tal representerar omfattningen av variansen eller mängden spridning mellan datapunkterna och det statistiska medelvärdet. Baserat på fördelningen av alla händelser som mäts i den allmänna populationen definieras värden som överskrider ett visst tröskelintervall (över och under) som avvikande värden.

Histogram över standardavvikelse för intäkter

Standardavvikelsen är cirka 225 $, så varje köp som överstiger detta genomsnitt med en standardavvikelse har passerat den gröna linjen 

Exempelvis kan en återförsäljare ge 2 000 köp per månad, fördelade på ett sätt som markerar belopp under 10 $ och över 500 $ som avvikande värden. De kommer sedan att använda denna tröskel i alla framtida tester för att filtrera bort enskilda händelser som kan snedvrida resultaten negativt. 

Alla tröskelvärden är dock inte skapade lika, så dessa värden bör övervägas noga innan varje A/B-testkampanj startas. Om man använder samma tröskelvärde för en målgrupp med ”storsimmare” kontra ”fyndjägare” leder det sannolikt till missvisande resultat. Alternativt kan ett test för mobil- och datoranvändare också drabbas av en liknande påverkan från extremvärden, eftersom dessa grupper traditionellt har olika genomsnittligt ordervärde. 


Hur ska A/B-testningsplattformar hantera avvikande värden 

Algoritmen som en del A/B-testprogramvara använder för att identifiera avvikande värden baseras på 68–95–99,7-regeln, en branschstandard där 99,7 % av den studerade populationen ligger inom tre standardavvikelser. (P.S. Detta är algoritmen som vi använder i Mastercard Dynamic Yield.) Det innebär att om vi samlar in avvikande händelser, som köp, och deras värde är tre gånger standardavvikelserna från genomsnittet markeras de som avvikande värden och hanteras därefter. 

Avvikelsetrösklar beräknas per händelse (t.ex. köp, bokning osv.) och för varje test, med hänsyn till experiment med både höga och låga trösklar, som i fallet med ”Big Spenders” och ”Bargain Hunters”. 

Diagram över variationsfördelningar efter testerna 1999

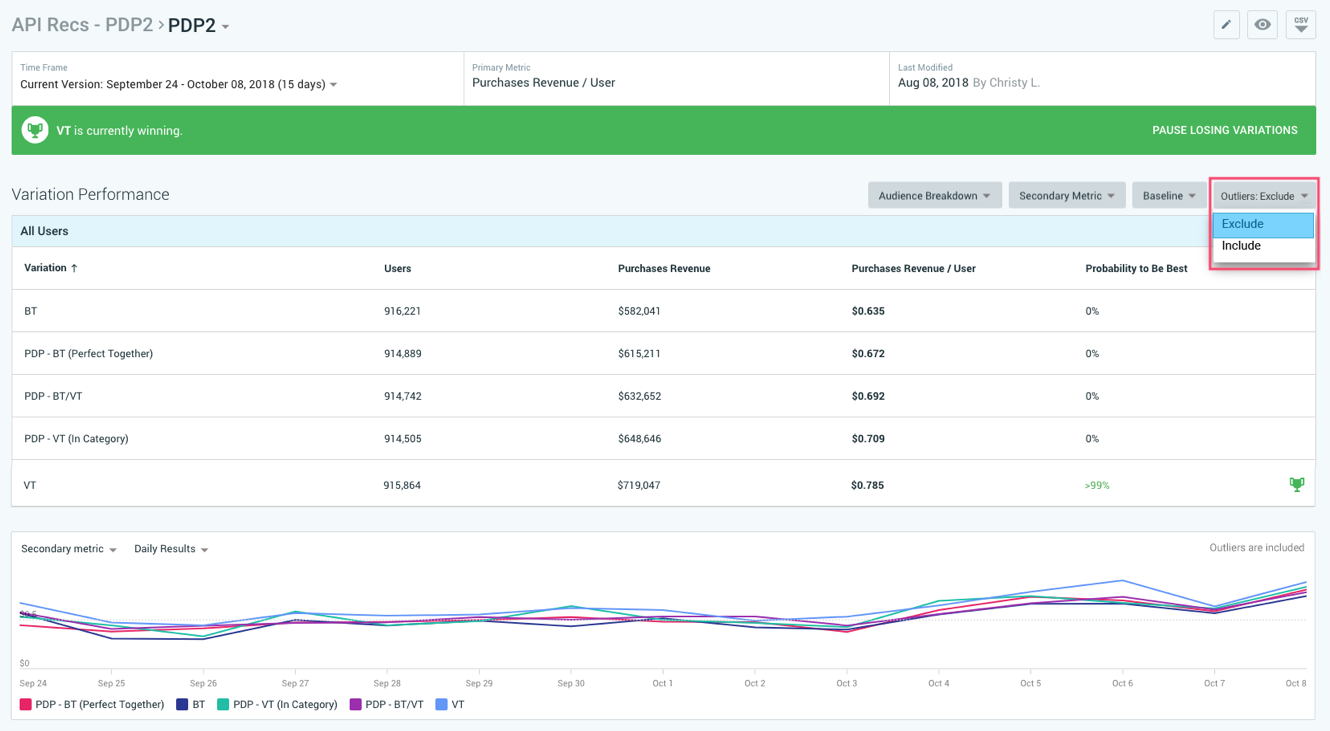
Vissa plattformar (som Experience OS) ger också möjlighet att välja om avvikande värden och händelser i utkantstområden ska inkluderas i rapporterna eller uteslutas helt. Dessutom kommer vinnande beräkningar att baseras på filtrerade avvikande händelser och påverka intäktsbaserade mätvärden. 


Rensa innan du spenderar

Genom att samla in datainsikter som inkluderar avvikande värden matas den personaliseringsplattform som används för att beräkna viktiga mätvärdeshändelser med information som är orelaterad till variationen och som inte är en bra förutsägelse för framtiden. Variationer som ursprungligen ansågs vara vinnare kommer sannolikt att få ett lägre genomsnittligt ordervärde på sikt, eftersom köp av avvikande värden sällan inträffar. Detta äventyrar inte bara kundupplevelsen, utan det slösar också bort värdefull tid i experimentprocessen, vilket leder till att man går miste om intäktsmöjligheter med högre avkastning. Med detektering av avvikande värden kan du mäta effekten av dina insatser på det mest tillförlitliga sättet som är möjligt. 

Kontakta säljavdelningen

Prata med en expert för att ta reda på hur Mastercard kan göra din verksamhet ännu bättre med hjälp av våra produkter och tjänster.

Mastercard