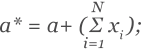
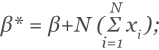
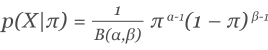
- from __future__ import print_function, division
- #! usr/bin/env python"
- __author__ = "SivaGabbi"
- __copyright__ = "Copyright 2019, Dynamic Yield"
- from builtins import rangev
- import matplotlib.pyplot as plt
- import numpy as np
- from scipy.stats import beta
- NUM_TRIALS = 2000
- CLICK_PROBABILITIES = [0.35,0.75]
- class Variation(object):
- def __init__(self, p):
- self.p = p
- self.a = 1
- self.b = 1
- def showVariation(self):
- return np.random.random() < self.p
- def sampleVariation(self):
- return np.random.beta(self.a, self.b)
- def updateVariation(self, x):
- self.a += x
- self.b += 1 - x
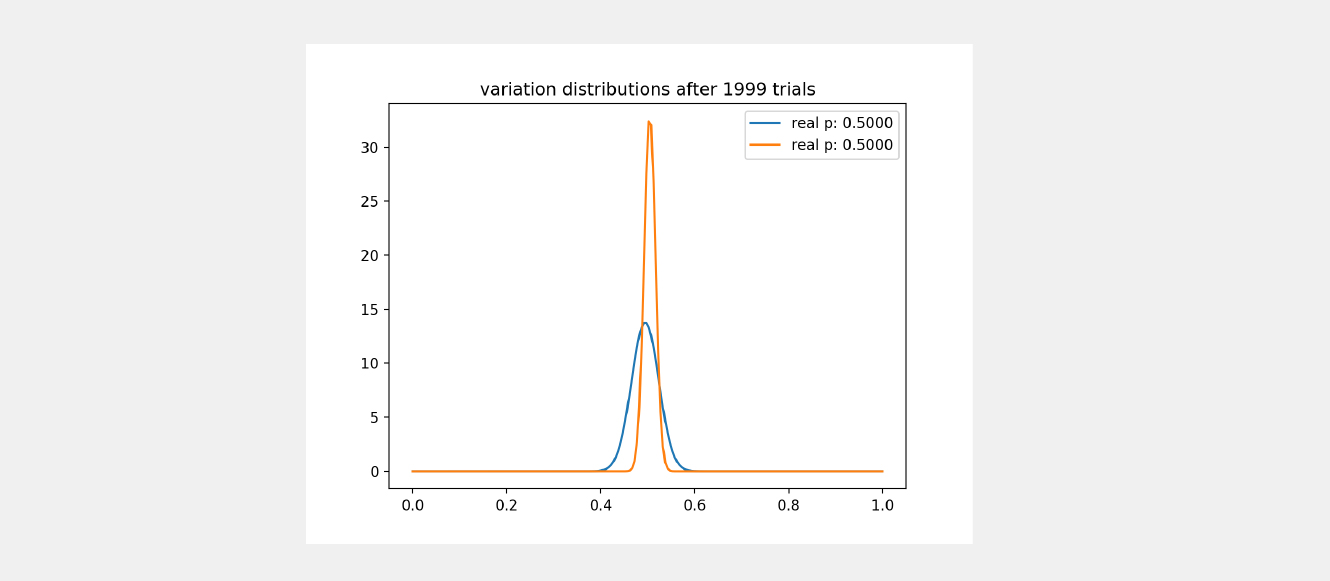
- def plot(variations, trial):
- x = np.linspace(0, 1, 200)
- for b in variations:
- y = beta.pdf(x, b.a, b.b)
- plt.plot(x, y, label="real p: %.4f" % b.p)
- plt.title("variation distributions after %s trials" % trial)
- plt.legend()
- plt.show()
- def experiment():
- variations = [Variation(p) for p in CLICK_PROBABILITIES]
- sample_points = [5,10,20,50,100,200,500,1000,1500,1999]
- for i in range(NUM_TRIALS):
- # ta ett urval från varje variant
- bestv = None
- maxsample = -1
- allsamples = []
- for v in variations:
- sample = v.sampleVariation()
- allsamples.append("%.4f" %-prov)
- if sample > maxsample:
- maxsample = sample
- bestv = v
- if i in sample_points:
- print("current samples: %s" % allsamples)
- plot(variations, i)
- # visa variationen med det största urvalet
- x = bestv.showVariation()
- # uppdatera distributionen för den variation som just samplades
- bestv.updateVariation(x)
- if __name__ == "__main__":
- experiment()

För er
Hitta ett kort
Olika sätt att betala
För din trygghet
Upplev Mastercard
För företag
Utforska olika lösningar
Utforska efter branschsegment
För världen
Vi ger människor möjligheter
Vägar till framgång
Värna om planeten
För innovatörer
Bygg med oss
Bli vår partner
Utforska med oss
Engagera dig
Nyheter och trender
Utvalda ämnen
Insikter och rapporter
Pressresurser
Investerarrelationer