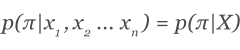
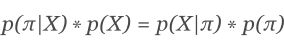
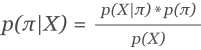
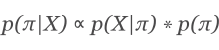
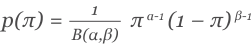
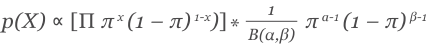
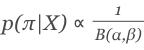
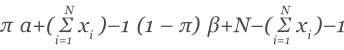
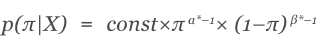
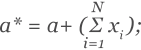
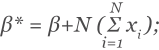
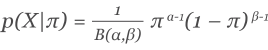
Saltar al contenido principal

Lección

El enfoque bayesiano de las pruebas A/B

Desde la ideación hasta la ejecución y el análisis, los datos y la analítica pueden ayudar a los profesionales del marketing en cada etapa, convirtiendo cualquier negocio en un líder del sector impulsado por los datos.

Siva Gabbi profile photo

Siva Gabbi

Manager, Specialist Sales,

Mastercard

Las aplicaciones de las pruebas A/B son muy antiguas y se extienden a través de diversas industrias, desde las pruebas de medicamentos médicos hasta la optimización de experiencias dentro del comercio electrónico. Pero a medida que las herramientas utilizadas para tomar decisiones informadas basadas en los datos recopilados continúan evolucionando, también lo hace el mejor enfoque. 

Una vez universalmente aceptado, el enfoque frecuentista de la inferencia estadística en escenarios de pruebas A/B está siendo sustituido por un nuevo patrón oro. Basado también en los fundamentos de las pruebas de hipótesis, el enfoque bayesiano es conocido por su naturaleza menos restrictiva, altamente intuitiva y más fiable. Aunque Mastercard Dynamic Yield ya ha hablado sobre el asunto, mi objetivo es profundizar en las cifras que hay detrás de la escuela de pensamiento bayesiana, realizando las derivaciones oportunas cuando sea necesario. 


Filosofía fundacional de los métodos bayesianos: 

En un enfoque bayesiano, todo es una variable aleatoria y, por extensión, tiene una distribución de probabilidad y unos parámetros. 

En la estadística frecuentista, si queremos modelizar la tasa de clics de un grupo, intentamos encontrar su media y su varianza, que actúan como parámetros. Y para encontrar estos parámetros, recopilamos información de datos de muestra, anotamos la verosimilitud y luego la maximizamos con respecto a los parámetros. A continuación, creamos intervalos de confianza en torno a esta tasa de clics de máxima verosimilitud para cuantificar la incertidumbre sobre dónde se situaría la media real. 

En la estadística bayesiana, la media real es una distribución, pero las observaciones son fijas, lo que modela la toma de decisiones en la vida real mucho mejor. Para ser más precisos, en el caso de una distribución de Bernoulli, la función de masa de probabilidad (fmp) se define como:

Siendo π la probabilidad de clic. 

Aquí, según el enfoque bayesiano, $\pi$ también debería tener su propia distribución, sus propios parámetros, etc. 


Distribución de probabilidad media y sus parámetros:

Para calcular la tasa de clics media, de forma similar al valor medio de máxima verosimilitud en una prueba A/B tradicional, intentamos resolver el valor π en la ecuación siguiente: 

Donde X = los datos observados obtenidos. 

Aplicamos la clásica ecuación de probabilidad condicional bayesiana:

Aquí, p(X) puede tratarse como una constante de normalización, dada su independencia de π.

Por lo tanto: 

p(π) = probabilidad de clic antes de empezar el experimento (la distribución a priori)
p(X|π) = muestras de datos observados (la verosimilitud)
p(π|X) = probabilidad de clic tras observar la muestra (la distribución a posteriori)


Distribuciones de probabilidad a priori, de verosimilitud y a posteriori

Podemos calcular que el valor p(X) (probabilidad de clics) a partir de los datos de la muestra observada es un producto de la probabilidad a priori y la verosimilitud. Aquí, la probabilidad a priori es la probabilidad de hacer clic en una variación antes de recopilar cualquier información de datos de muestra (esto equivaldría al promedio histórico de un experimento o, en ausencia de datos, a una distribución uniforme); por otro lado, la verosimilitud es la distribución de probabilidad de la información de los datos de muestra recopilados.

Para resolver esta ecuación, explotamos un concepto llamado «prior conjugado». En la teoría de la probabilidad bayesiana, si la distribución a posteriori tiene la misma distribución de probabilidad que la distribución de probabilidad a priori dada una función de verosimilitud, entonces la a priori y la a posteriori se denominan distribuciones conjugadas. La distribución a priori se denomina prior conjugado para la función de verosimilitud.

En nuestro caso, si la función de verosimilitud se distribuye según una distribución de Bernoulli, elegir una distribución a priori beta para la media garantizará que la distribución a posteriori también siga una distribución beta. En esencia, la distribución beta es una distribución a priori conjugada para la verosimilitud que se distribuye según una distribución de Bernoulli. 

Veamos cómo el uso de este concepto nos ayuda a resolver la probabilidad posterior para variables tanto continuas como binarias.

Variables binarias

Como estamos tratando con una distribución de Bernoulli, solo tenemos que lidiar con una variable aleatoria (π). Suponiendo que nuestra función de verosimilitud sigue una distribución beta a priori: 

Suponiendo también que el experimento comienza sin prejuicios, una distribución beta para la prioridad con α=1; β=1 sería un buen punto de partida, ya que beta (1,1) es una distribución uniforme: 

Agrupación de los términos similares: 

Podemos ver que la distribución a posteriori es simplemente una distribución beta de la forma:

Dónde:

Lo cual es igual a nuestra distribución de probabilidad anterior:

Por lo tanto, se confirma el concepto de aprietes conjugados para resultados binarios.

Para resolver una probabilidad a posteriori para resultados binarios, el modelo sería:

  1. π ~ Beta (1,1): asume que la distribución a priori es uniforme
  2. Muestra x1
  3. π ~ Beta (1+x1 ,1+1- x1): actualiza la distribución beta para reflejar los datos de la muestra observada
  4. Muestra x2
  5. π ~ Beta (1 + $x^2$, 1 + $2^{-x^2}$)
  6. Repetir desde el paso 2

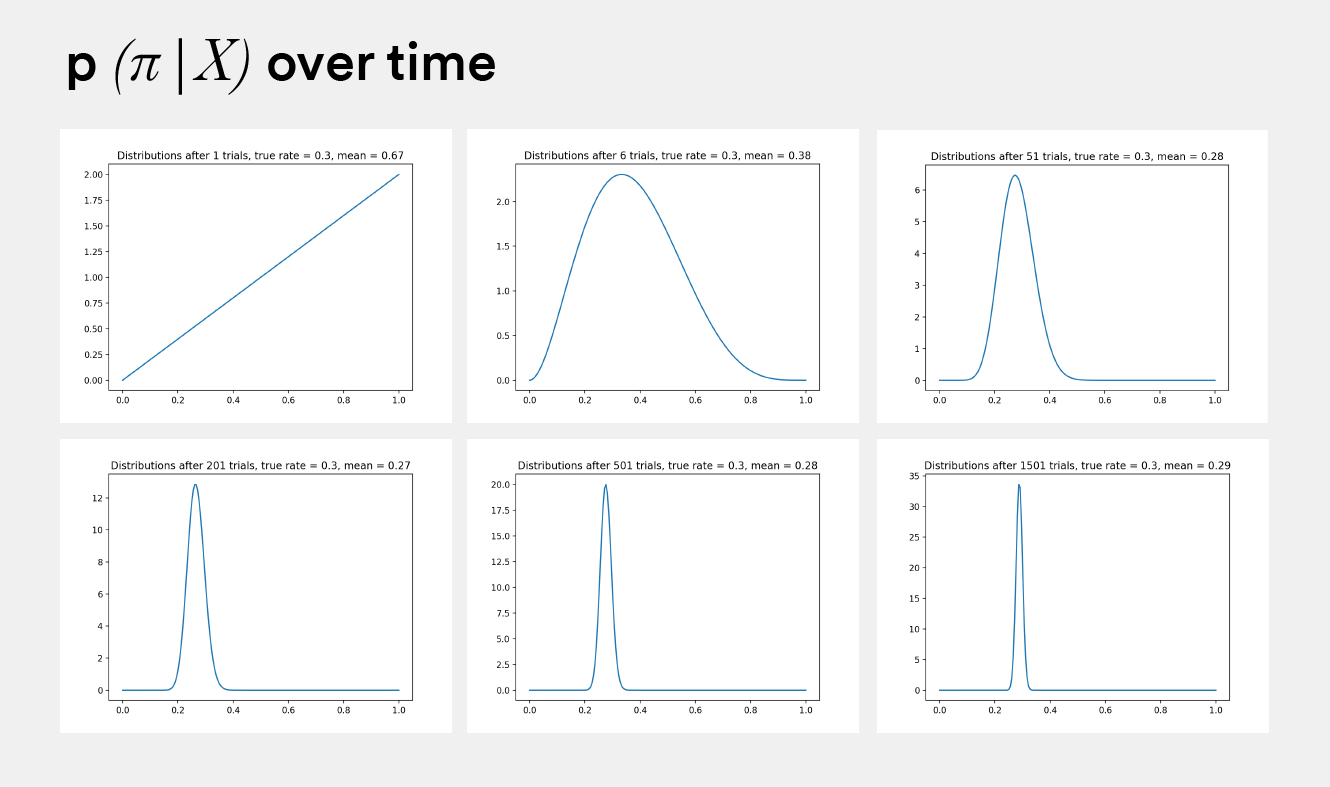
Al final, llegamos a una distribución beta que progresa desde una distribución uniforme hasta una distribución normal y estrecha.

The following code, implemented in Python, will allow you to more easily visualize the progression, effectively demonstrating how the Bayesian probability changes over time as the number of samples increase

  1.     from __future__ import print_function, division
  2.  
  3.  
  4.        #! usr/bin/env python"
  5.     __author__ = "SivaGabbi"
  6.     __copyright__ = "© Copyright 2019, Dynamic Yield"
  7.  
  8.  
  9.     from builtins import rangev
  10.     import matplotlib.pyplot as plt
  11.     import numpy as np
  12.     from scipy.stats import beta
  13.  
  14.  
  15.     NUM_TRIALS = 2000
  16.     CLICK_PROBABILITIES = [0,35,0,75]
  17.  
  18.  
  19.     class Variation(object):
  20.     def __init__(self, p):
  21.     self.p = p
  22.     self.a = 1
  23.     self.b = 1
  24.  
  25.     def showVariation(self):
  26.     return np.random.random() < self.p
  27.  
  28.     def sampleVariation(self):
  29.     return np.random.beta(self.a, self.b)
  30.  
  31.     def updateVariation(self, x):
  32.     self.a += x
  33.     self.b += 1 - x
  34.  
  35.  
  36.     def plot(variations, trial):
  37.     x = np.linspace(0, 1, 200)
  38.     for b in variations:
  39.     y = beta.pdf(x, b.a, b.b)
  40.     plt.plot(x, y, label="real p: %.4f" % b.p)
  41.     plt.title("variation distributions after %s trials" % trial)
  42.     plt.legend()
  43.     plt.show()
  44.  
  45.  
  46.     def experiment():
  47.     variations = [Variation(p) for p in CLICK_PROBABILITIES]
  48.  
  49.     sample_points = [5,10,20,50,100,200,500,1000,1500,1999]
  50.     for i in range(NUM_TRIALS):
  51.  
  52.     # tomar una muestra de cada variación
  53.     bestv = None
  54.     maxsample = -1
  55.     allsamples = []
  56.     for v in variations:
  57.     sample = v.sampleVariation()
  58.     allsamples.append("%.4f" % de muestra)
  59.     if sample > maxsample:
  60.     maxsample = sample
  61.     bestv = v
  62.     if i in sample_points:
  63.         print("current samples: %s" % allsamples)
  64.     plot(variations, i)
  65.  
  66.     # show the variation with the largest sample
  67.     x = bestv.showVariation()
  68.  
  69.     # actualizar la distribución de la variante que se acaba de muestrear
  70.     bestv.updateVariation(x)
  71.  
  72.  
  73.     if __name__ == "__main__":
  74.     experiment()

La progresión de π a lo largo del tiempo se puede ver como:

Gráficos de la progresión de pi a lo largo del tiempo

Variables continuas

Como estamos tratando con una distribución de Bernoulli, solo tenemos que lidiar con una variable aleatoria (π). Suponiendo que nuestra función de verosimilitud sigue una distribución beta previa:
 

Variables discretas:

Para optimizar métricas discretas, como el número de compras, visitas a páginas, etc., trabajamos con una distribución a priori gamma y una función de verosimilitud de Poisson. Lo que, de nuevo, da como resultado una distribución a posteriori gamma.


Asignación dinámica / Dilema de exploración y explotación / Bandido de múltiples brazos

Imagina que estás en un casino y, de dos máquinas tragaperras, eliges una y ganas 3/3 de las veces que juegas. ¿Cuál sería tu próximo movimiento? ¿Seguirías jugando con la máquina que ha demostrado ganar o probarías la otra? 

Esta situación resume con precisión el dilema de exploración y explotación (la elección entre recopilar más información de los datos y maximizar los beneficios), que, como ya hemos descrito, se aplica estrechamente a las pruebas A/B. 

En una prueba A/B tradicional, dado que asignas un porcentaje del tráfico, no hay opción de aprovechar la información de los datos, es decir, asignar de forma incremental más tráfico a la variante ganadora. 

Veamos cómo se logra esto en un entorno bayesiano. 

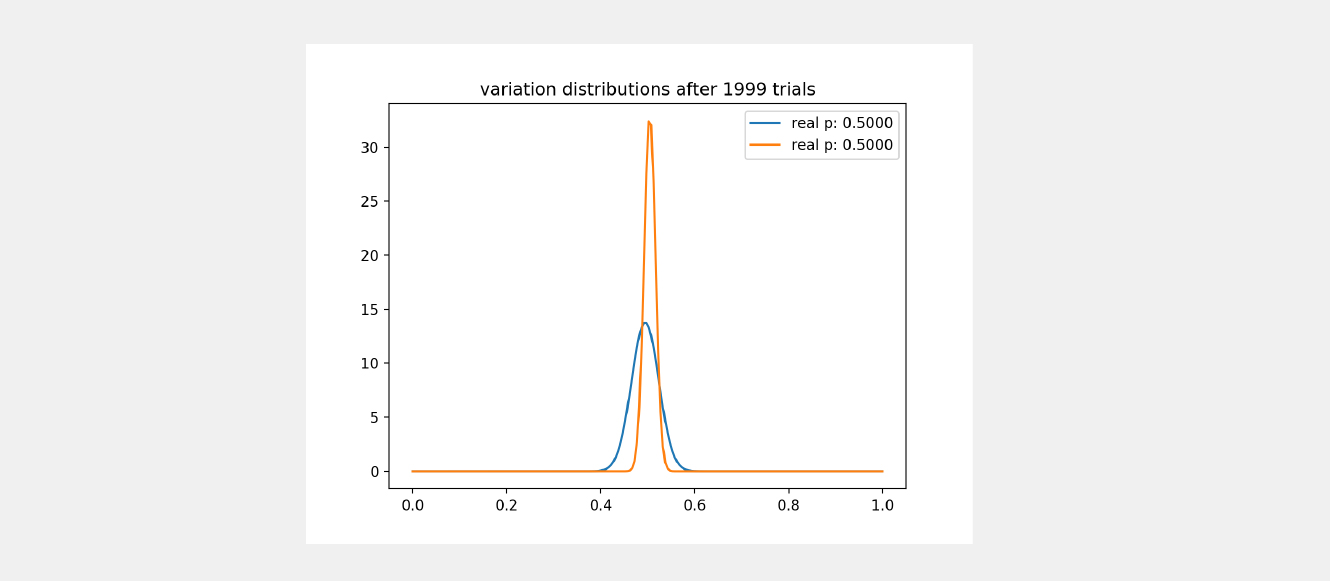
En resumen, el muestreo se encarga por completo del dilema de exploración-explotación para nosotros en una prueba bayesiana. Digamos que has distribuido el tráfico aleatoriamente entre dos variaciones (azul y naranja) y has alcanzado la siguiente distribución de probabilidad posterior para ambas: 

Gráfico de distribuciones de variación después de las pruebas de 1999

Como se puede ver, la variación naranja se muestra claramente en muchas más muestras que la variación azul. ¿Y cómo reconocemos esto? ¡La variación! Vimos antes que una probabilidad a posterior se vuelve más estrecha con más datos de muestras, así que, dado que la variación azul sigue siendo más ancha, podemos concluir que no tiene suficientes muestras. 

En este punto, si decidimos tomar una muestra aleatoria de dos puntos, uno de cada variación, y comparar ambos, ¿qué probabilidades hay de que la variación naranja sea mayor? 

  1. Si la muestra de la variación azul procede de la mitad derecha del gráfico, entonces tendrá una mayor probabilidad de ser más alta 

  1. Si la muestra de la variación azul proviene de la mitad izquierda del gráfico, probablemente sería inferior a la de la variación naranja. 

¿Qué sucede si decidimos la variación que se mostrará a continuación en función de cuál tiene el mayor valor en este muestreo aleatorio? 

→ Si la variación azul gana, se mostrará junto al público, lo que ampliará su muestreo a la vez que reducirá la variación en torno a una probabilidad fija de su valor medio real. Aquí vemos dos posibilidades adicionales: 

  • Su probabilidad final > probabilidad de la variación naranja: si el muestreo continúa, la variación azul seguiría ganando 

  • Su probabilidad final < la probabilidad de la variación naranja: la variación naranja se muestreará más y seguirá mostrándose 

→ Si la variación azul pierde, se muestra la variación naranja. 

Por lo tanto, el muestreo se encarga del dilema de exploración-explotación por nosotros, tomando siempre la mejor decisión en nuestro nombre. 


Declaración de un ganador 

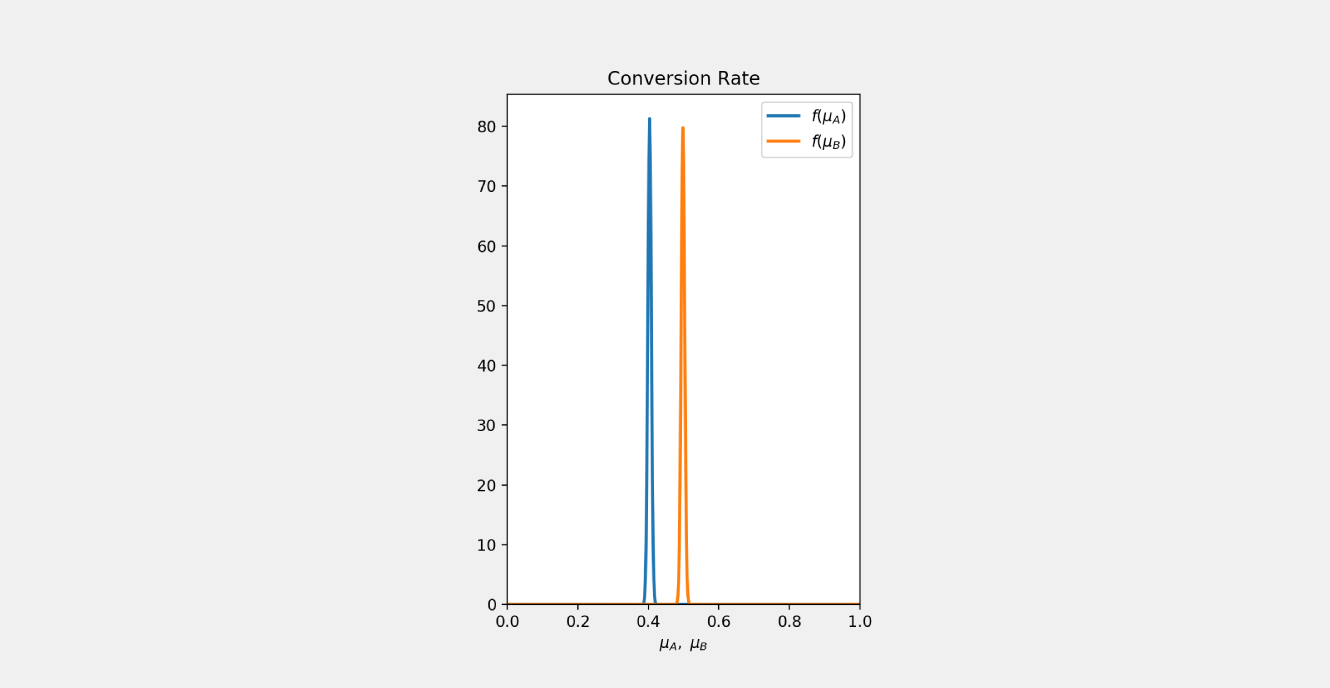
Una vez que se asignan las distribuciones posteriores para las variantes, para determinar un ganador, se toma una gran cantidad de muestras de observaciones. Hipotéticamente, digamos que tomas 1000 muestras de dos variantes y 999 de cada 1000 veces ves que la variante naranja tiene mayor probabilidad: 

Gráfico de la tasa de conversión

La probabilidad de que la variación naranja sea mejor que la variación azul será (999/1000) * 100, es decir, un 99,9 %. 

En Mastercard Dynamic Yield, realizamos 300 000 muestras de cada variación para calcular la probabilidad de ser la mejor opción (P2BB). 


Posibilidad de explorar y explotar

Al realizar una prueba A/B tradicional en la que una variación supera claramente a otra, la variación perdedora sigue mostrándose a una gran audiencia hasta que se alcanza la significación estadística. Si bien permite declarar con confianza al ganador, el tiempo de espera puede provocar la pérdida de negocio potencial. 

En un mundo ideal, deberías poder retirar el tráfico de la variante perdedora y maximizar los beneficios con la variante ganadora. Para dar a la variante perdedora la oportunidad de tomar la delantera, le asignamos un porcentaje mínimo de tráfico (llamado épsilon) y explotamos la variante ganadora. Así surgió el término «explorar frente a explotar» (también denominado «épsilon-voraz» en algunos ámbitos), que aborda cuánto tiempo se «desperdicia» en aprender en lugar de aprovechar lo que ya se ha aprendido. Esta función es casi imposible en una prueba A/B tradicional, a menos que estés empeñado en producir falsos positivos.


Resumen bayesiano

Recapitulación de todo lo expuesto hasta el momento: 

  • Las pruebas A/B bayesianas convergen más rápido que una prueba A/B tradicional con datos de audiencia de muestra más pequeños debido a sus suposiciones menos restrictivas 

  • Alcanzar la significación es «incremental» por naturaleza en las pruebas A/B bayesianas. Puedes consultar los valores en cualquier momento y decidir suspender el experimento 

  • Probabilidad insignificante de un error de falso positivo 

  • La estrategia de exploración y explotación en las pruebas bayesianas no deja dinero sobre la mesa. 

Para concluir, la industria avanza hacia el marco bayesiano, ya que es un enfoque más sencillo, menos restrictivo, altamente intuitivo y más fiable para las pruebas A/B. De hecho, Mastercard Dynamic Yield ha adoptado un motor estadístico bayesiano, no solo para objetivos binarios como la tasa de conversión de objetivos y el CTR, sino también para objetivos no binarios como los ingresos por usuario. 

Si quieres obtener más información sobre los problemas presentados en el enfoque frequentista, consulta esta entrada de blog. 

Ponte en contacto con ventas

Habla con un experto para descubrir cómo Mastercard puede mejorar tu negocio a través de nuestros productos y servicios.

Mastercard