Lärdom

Framväxten av system för rekommendationer baserade på djupinlärning, transformerarkitektur och stora språkmodeller 

När varumärken inom olika branscher fortsätter att anamma djupinlärning kan du lära dig hur den anpassas för leverans av produktrekommendationer som förbättrar kundupplevelsen och genererar meningsfulla intäkter. 

Gidi Vigo profile photo

Gidi Vigo

Vice President of Product,

Dynamic Yield,

Mastercard

Framtiden för personalisering och produktrekommendationer kommer i hös grad att formas av djupinlärning, transformatormodeller och stora språkmodeller (LLM) samt deras förmåga att förutsäga en besökares nästa naturliga artikel eller produkt.

Låt oss gå igenom några av de viktigaste begreppen bakom djupinlärning, varför det börjar become mer allmänt accepterat och hur dess mycket effektiva tillämpning inom naturlig språkbehandling (NLP) anpassas till djupinlärningsbaserade rekommendationsmotorer.

Vad är egentligen djupinlärning?

Under det senaste decenniet har den vetenskapliga världen fascinerats av den enorma framgången för metoder inom djupinlärning, vilka spelar en stor roll för hur artificiell intelligens (AI) har blomstrat under de senaste åren. De mest anmärkningsvärda av dessa revolutioner har möjliggjorts inom datorseende och naturlig språkbehandling (NLP).  

Djupinlärning är ett underområde till maskininlärning (ML) som handlar om algoritmer inspirerade av hjärnans struktur och funktion. När forskare talar om djupinlärning syftar de på en familj av algoritmer som abstraktionsmässigt ser ut och fungerar som det mänskliga neurala nätverket. I grund och botten finns det ett antal neuronnoder som är sammankopplade som ett nät, där var och en tar emot indata, bearbetar dem och sedan skickar ut bearbetad information till närliggande noder. 

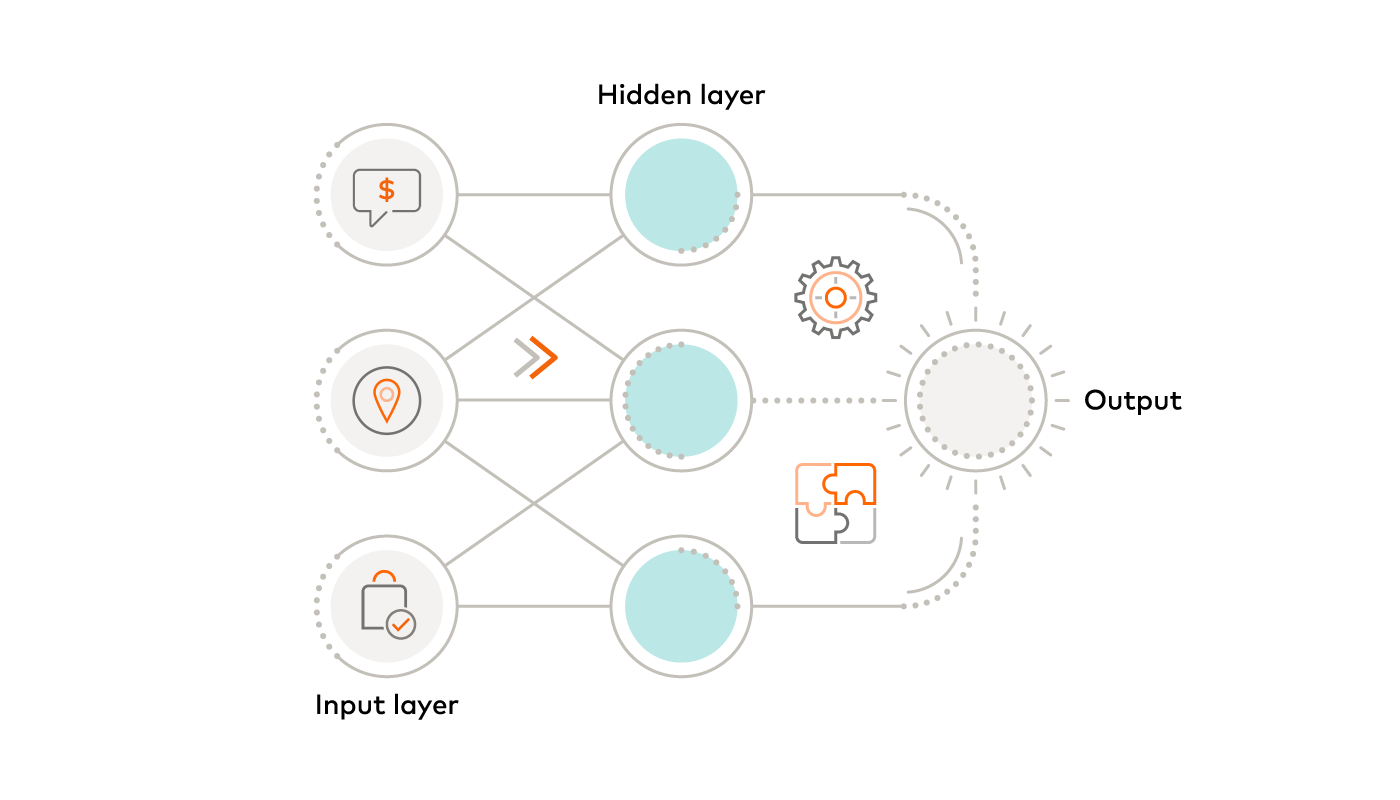
Arkitekturen för alla modeller för djupinlärning innefattar en flerskitsstruktur där varje skikt består av noder som utför en viss matematisk åtgärd, vilket kallas aktiveringsfunktion. 

Det är vanligt att skilja mellan tre typer av skikt: inmatning, dolt och utmatning. 

Grundarkitekturen för en algoritm för djupinlärning

Djupinlärningens ökande popularitet 

Det finns flera skäl till varför djupinlärning blir allt vanligare; det första är en stor konsolidering mellan den beräkningskapacitet som krävs för djupinlärning och en konsekvent tillväxt i molnbaserade maskiners prestanda. 

Medan de allra flesta traditionella ML-modellerna analyserar datainsikter på ett linjärt sätt möjliggör djupinlärningssystemets arkitektur bearbetning av datainsikter på ett icke-linjärt sätt. Detta ger djupinlärningsalgoritmer möjlighet att bli mer effektiva när det gäller att identifiera och agera på värdefulla insikter. 

Men den största fördelen med djupinlärning är dess förmåga att automatiskt skapa ytterligare funktioner. Funktioner är variabler som ålder, region, veckodag osv. som används för att förutsäga hur en användare interagerar med en webbplats, till exempel genom att köpa en vara. Till skillnad från traditionell maskininlärning bygger djupinlärning upp många nya funktioner baserat på olika, ofta oförklarliga, kombinationer från en ursprunglig uppsättning givna funktioner.


Så varför löses inte alla maskininlärningsproblem med djupinlärning?  

Bland de främsta orsakerna är att djupinlärningsalgoritmer endast har fördelar gentemot traditionella maskininlärningsalgoritmer när det finns tillräckligt med datainsikter. Maskininlärningsalgoritmer kräver färre datainsikter och är därför att föredra i många fall.   

Tekniker för djupinlärning kräver också mer tid för träning och därmed en mer kapabel infrastruktur för att hantera de beräkningar som krävs, vilket kan öka serverkostnaderna. Slutligen är tolkningsbarheten för djupinlärningsbaserade beslut lägre än för klassiska maskininlärningsalgoritmer, eftersom flera omvandlingar under modelleringen gör det svårt att förstå den rena effekten av indata på utdataresultatet. 


Och så fanns det djupinlärningsbaserade rekommendationer 

På senare tid har djupinlärning gjort sitt intåg i en värld av rekommendationsarkitekturer, tack vare den perfekta parallellen mellan NLP och rekommendationsramverk. Båda domänerna har en sekventiell natur och är sugna på att förstå vad nästa naturliga objekt är i en sekvens.

Ta e-postleverantörer som exempel. Vissa kan förutsäga nästa ord i en mening när du skriver ett e-postmeddelande. Föreställ dig nu att varje ord som skrivs under utkastet är en lista över produkter som en besökare har interagerat med. Exakt samma koncept kan tillämpas på rekommendationer. Och även om detta frigör ett extremt kraftfullt verktyg för e-handelsvarumärken är det fortfarande bara början, med ett brett utbud av framtida möjligheter som blir tillgängliga för att hantera utmaningarna med rekommendationer. 

Deep learnings förmåga att fånga upp icke-linjära och icke-triviala samband mellan användare och produkter samt att integrera omfattande information gör den nästan begränsad, vilket ger en kvalitet på rekommendationer som branschen hittills inte har kunnat uppnå. 

Sådan information inkluderar, men är inte begränsad till: 

  • Kontextuellt: Dag, väder, aktualitet, engagemangstyp, artikelpris och sida 

  • Textbaserat: En produkts nyckelord och recensioner, användarens sökfråga

  • Visuellt: Den visuella likheten mellan produkter

Status för djupinlärning inom rekommendationer

När man tittar på forskningens inriktning och den aktuella utvecklingen inom djupinlärning kan dess användning för att driva rekommendationsmotorer delas in i tre kategorier.  

  • Innehållsbaserade rekommendationer utnyttjar användarens intressen och produktbeskrivningen fullt ut för att generera rekommenderade artiklar. 

  • Rekommendationer baserade på samarbetsfiltrering använder användarens sökhistorik och preferenser utan personlig information, till exempel användarens betyg på artikeln, för att generera rekommenderade artiklar. 

  • Hybridmetodens rekommendationer syftar till att uppnå bästa möjliga rekommendationsresultat genom att kombinera innehålls- och kollaborativ filtreringsbaserade rekommendationsmetoder. 

Samarbetsfiltrering har länge varit branschstandard och har antagits av branschen som den huvudsakliga metoden för att leverera personliga rekommendationer. Genom att använda en användar-produkt-matris för rangordning känner samarbetsfiltrering igen den höga sannolikheten för att Jennifer också skulle vara intresserad av artikel C om en användare som heter Jennifer visar intresse för artikel A och B, och andra kvinnor har interagerat med artikel A, B och C. 

Men medan samarbetsfiltrering har en bred tillämpning och kan rekommendera ett brett utbud av produkter med stor träffsäkerhet utan att behöva förstå kärnan i en viss artikel, erbjuder djupinlärning en helt ny nivå av sofistikering.  

Item2Vec-algoritmer

Genom att låna NLP-tekniken word2vec – eller inom e-handel item2vec – analyserar djupinlärningsalgoritmerna förekomsten av artiklar i användarens sökhistorik och genererar rekommendationer med högre träffsäkerhet.   

Eftersom item2vec är en djupinlärningsbaserad metod har den också ett antal tekniska fördelar: 

  • Skala: Kan tränas på en enorm mängd datainsikter. 

  • Relevans: Kan tränas mycket snabbt och frekvent tack vare möjligheten att träna en sådan modell med endast ett dolt lager. Därför tar den hänsyn till de senaste ändringarna på webbplatsen. 

  • Katalogtäckning: Inga begränsningar för flödets längd – alla produkter tränas och har en chans att rekommenderas till användaren. 

  • Realtid: Baserat på den senaste onlinekontexten returneras rekommendationer med mycket låg latens. 

Här är lite mer information om hur det fungerar. 

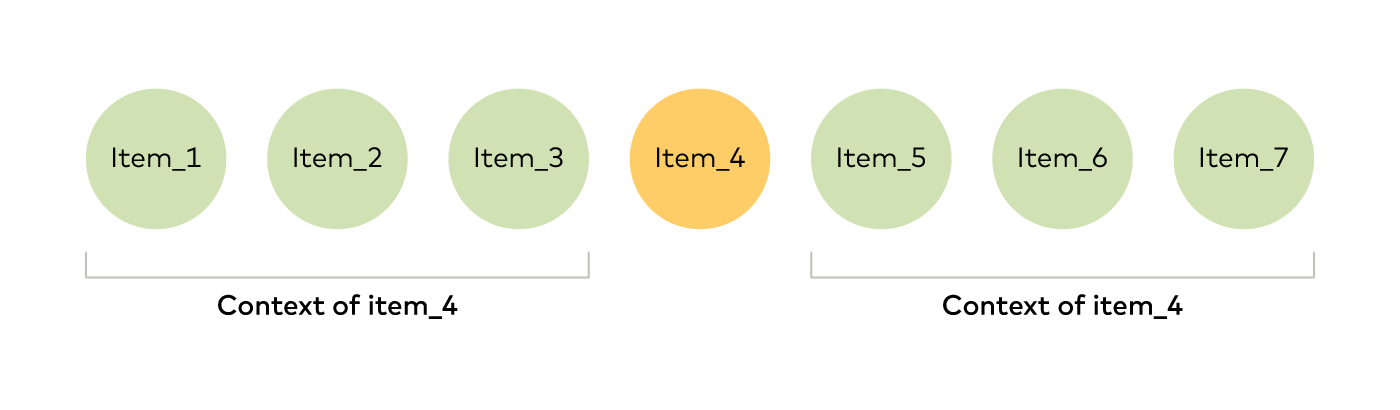
Item2vec är en representation av ett ord med hjälp av en numerisk vektor som erhålls från djupinlärningsmodellering av samförekomst av artiklar. En sådan vektor kodar enormt viktig information om andra närliggande artiklar som förekommer tillsammans med en specifik artikel. Dessa närliggande artiklar kallas kontext. 


En serie objekt som förekommer tillsammans. Item_4 är ett inlärt objekt och de omgivande objekten kallas kontext

Med item2vec kan en artikel härledas från kontexten, vilket är de artiklar som tenderar att finnas i dess närhet. Liknande omgivningar för två artiklar innebär liknande konsumtionsmönster för själva artiklarna. Och ju oftare två objekt förekommer i liknande kontexter, desto närmare varandra ligger deras representativa vektorer. 

När varje artikel i en katalog representeras av en numerisk vektor och vektorernas likhet återspeglar artiklarnas kontextuella likhet, är vi redo att servera ”huvudrätten”, så att säga, med de mest relevanta artiklarna baserat på användarens senaste intressen. Detta görs enkelt genom att hitta artiklar med vektorer som liknar vektorerna för nyligen engagerade produkter. En sådan likhet mellan vektorer kallas cosinuslikhet, och eftersom artiklar med högst cosinuslikhet förväntas vara mycket relevanta bör de rekommenderas till användaren. 

Word2Vec-algoritmer är dock inte utan begränsningar. De använder ett glidande fönster med fast storlek för att fånga upp kontext, vilket är begränsat till 5–10 ord. Vidare lär de sig ordrepresentationer genom att antingen förutsäga målordet utifrån dess kontext (det vi kallar CBOW, eller continuous bag-of-words), eller vice versa (Skip-Gram). Som ett resultat är ordinbäddningar statiska, vilket innebär att varje ord har samma vektor – oavsett dess kontext i olika meningar. Ta de här två meningarna: ”I went to the bank” vs ”I went to the river bank.” I det här fallet skulle ordet ”bank” få samma representation, i stället för något som återspeglar dess finansiella kontra geografiska betydelse. 

Det finns en utväg ur det här problemet, men det kräver ett annat tillvägagångssätt för att fånga upp meningens ”kontext”. Möt Transformer-modellerna. 

Så revolutionerar AI shoppinguppelsen: historien om transformatorn

Har du någonsin undrat hur din strömningsplattform vet vilken serie den ska rekommendera härnäst, eller hur e-handlare kan föreslå den perfekta produkten? Denna transformation skedde inte över en natt. Det är resultatet av en fascinerande resa som började med introduktionen av en kraftfull teknik – en typ av djupt neuralt nätverk som kallas transformatoranalys – år 2017. Sedan dess känns onlineshopping mer som att ha en personlig assistent som känner till din smak bättre än du själv gör. 

När transformer-modeller tillämpas på e-handel kan de fungera som otroligt uppmärksamma shoppingkompisar. Precis som en vän som minns att du älskar klänningar i vintagestil eller miljövänliga produkter kan dessa AI-modeller få en uppfattning om din smak. Men de gör det i en skala som ingen människa kan matcha, och bearbetar miljontals shoppingmönster samtidigt.

Vad är egentligen transformer-modeller? 

Transformermodeller representerar ett revolutionerande framsteg inom djupa neuronnätverk, sida vid sida med andra arkitekturer som RNN- och CNN-modeller. Det som gör dem speciella är deras anmärkningsvärda självuppmärksamhetsmekanism – en funktion som fungerar förvånansvärt likt mänsklig perception. 

Tänk dig att du befinner dig på en fullsatt fest. Trots det buller och de många konversationer som pågår omkring dig kan du fokusera på en enda persons röst samtidigt som du filtrerar bort allt annat. Det är exakt så här självuppmärksamhetsmekanismen fungerar i transformatormodeller – den kan bearbeta flera informationsdelar samtidigt samtidigt som den identifierar och fokuserar på de mest relevanta delarna. 

Till skillnad från word2vec-algoritmer kan transformers fånga upp relationer mellan ord – oavsett avstånd i sekvensen. Transformers integrerar naturligt både vänster- och högerkontext för varje ord och begränsas inte av fönsterstorlek. Och medan word2vec-algoritmer kan bearbeta ord sekventiellt, bearbetar transformers alla ord samtidigt, vilket gör att de kan fånga mer komplexa relationer mellan ord.  

Transformers använder också positionskodning för att behålla information om ordningsföljd, vilket word2vec inte hanterar explicit. De har uppmärksamhet med flera huvuden (multi-head attention), vilket innebär att de kan lära sig om flera typer av relationer mellan ord genom olika uppmärksamhetshuvuden samtidigt.

Så fungerar self-attention-mekanismen

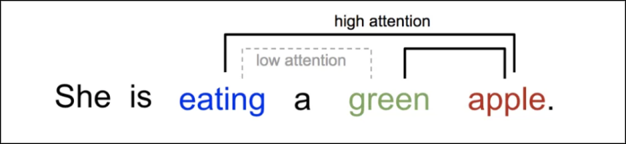
Se självuppmärksamhet som ett sätt för ord att "titta på" andra ord i en mening för att förstå deras korrekta betydelse och sammanhang. Den här bilden demonstrerar självuppmärksamhet genom ett enkelt textexempel: "He is eating a yellow banana." På samma sätt som vi människor naturligt förstår att "yellow" specifikt beskriver "banana" i den här meningen, skapar självuppmärksamhet starkare kopplingar (hög uppmärksamhet) mellan relaterade ord som "yellow" och "banana", samtidigt som svagare kopplingar (låg uppmärksamhet) upprätthålls med mindre relaterade ord.

Textexempel på självuppmärksamhetsmekanism – ”hög” vs. ”låg” uppmärksamhet 

Den stora fördelen är att varje ord direkt kan ansluta till vilket som helst annat ord i meningen, oavsett deras placering, vilket hjälper modellen att bättre förstå relationer och innebörd i språket. Självuppmärksamhet sträcker sig långt bortom textbearbetning till visuell förståelse. Vi kan se dess kraft genom ett exempel med detaljerad analys av en katt.  

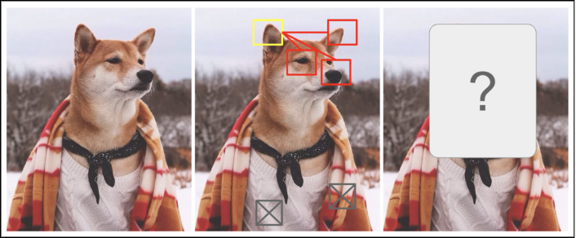
Tänk på self-attention som att skapa en dynamisk karta över relationer i en bild. När man undersöker en katt fungerar mekanismen som en uppmärksam observatör som samtidigt analyserar flera visuella kopplingar. De färgade rutorna och sammanlänkande linjerna i visualiseringen representerar dessa relationer – till exempel hur modellen känner igen att kattens utmärkande spetsiga öron är meningsfullt sammankopplade med dess alerta ansiktsuttryck liknar hur människor naturligt uppfattar bilder. I stället för att analysera varje särdrag hos katten isolerat – öron, ansikte, svans eller kroppsform – bygger modellen upp en förståelse genom samspelet mellan elementen i de tre röda rutorna och förutspår exakt vad som kommer att dyka upp i den gula rutan. Men om bara kattens kropp är synlig kan den inte generera ett korrekt ansikte. 

Visuellt exempel på självuppmärksamhetsmekanismen – detta koncept sträcker sig bortom text 

Tillämpningar av transformatormodellen 

Låt oss gå igenom hur detta AI-drivna genombrott omformar våra shoppingupplevelser på många sätt under vår shoppingresa:

  • Sekventiella rekommendationssystem: Dessa system analyserar nu hela det tidsmässiga mönstret för användarinteraktioner, och går bortom enkla produktrelationer för att förstå hela kundresan. Genom sin självuppmärksamhetsmekanism kan transformatorer fånga både långsiktiga preferenser och omedelbar shoppingavsikt, vilket skapar en dynamisk förståelse av användarnas behov som anpassar sig i realtid till föränderliga intressen och säsongsvariationer.

  • Visuellt och text: Sökfunktioner har förändrat produktupptäckten genom att överbrygga klyftan mellan hur kunder tänker och hur de handlar. Multimodala transformatorer möjliggör nu sömlös sökning i olika format, vilket gör att kunder kan hitta produkter med hjälp av bilder, text eller en kombination av båda. Nya funktioner gör att användare kan ladda upp foton på artiklar som de har sett någon annanstans och hitta relaterade produkter. Dessa system förstår semantiska relationer mellan produkter och går längre än enkel sökordsmatchning för att förstå den djupare innebörden bakom sökfrågor. 

  • Chattar: Intelligent konversationsassistans har utvecklats från enkla chattbotar till avancerade shoppingkompisar. Dessa AI-assistenter upprätthåller kontext över flera konversationer, erbjuder personliga rekommendationer genom naturlig dialog och förstår komplexa produktfrågor. De kan proaktivt engagera kunder baserat på shoppingmönster och vägleda dem genom processer för att upptäcka produkter i flera steg, vilket skapar en mer naturlig och hjälpsam shoppingupplevelse. 

  • Innehållsförbättring: Transformermodeller kan hjälpa till att generera engagerande, SEO-optimerade produktbeskrivningar samtidigt som en konsekvent ton och stil bibehålls i stora produktkataloger. De är utmärkta på att extrahera nyckelfunktioner från tillverkarnas datainsikter, generera innehåll på flera språk och sammanfatta kundrecensioner till användbara sammanfattningar, vilket säkerställer att produktinformationen är både heltäckande och tillgänglig.

Transformer-modellernas verkliga styrka ligger i deras förmåga att hantera långdistanskopplingar i text och datainsikter. När vi läser eller bearbetar information kopplar vi naturligt samman aktuell information med det vi har sett tidigare, oavsett hur långt tillbaka i tiden det var. Transformer-modeller replikerar denna förmåga genom sin självuppmärksamhetsmekanism, vilket gör dem exceptionellt bra på att förstå kontext och relationer. De kan arbeta med olika typer av datainsikter samtidigt och skapa AI-system som bättre efterliknar mänsklig förståelse och bearbetning. Men den verkliga magin uppstår när denna teknik kombineras med kraften hos stora språkmodeller (LLM). 

Kraften i LLM:er

Dessa modeller är byggda på en revolutionerande transformerarkitektur – samma byggstenar som bearbetar information genom att uppmärksamma relationer mellan ord och begrepp – och kan förstå kontext och generera mänskliga svar. Denna arkitektoniska grund gör det möjligt för språkmodeller (LLM) att fungera som otroligt mångsidiga verktyg som förstår kontext och förutser dina shoppingbehov. Det är som att ha en shoppingassistent som också är modeexpert, teknikguru och trendanalytiker i ett, som drivs av en arkitektur som kan bearbeta enorma mängder information och förstå komplexa mönster i kundernas preferenser.

Detta innebär följande för din shoppingupplevelse:

  • Mer exakta rekommendationer

  • Mindre tid slösas bort på att bläddra bland irrelevant innehåll

  • Personliga produktbeskrivningar som matchar dina specifika intressen

  • Anpassade shoppingguider baserade på din stil och dina preferenser

Men det handlar inte bara om att sälja mer. De här systemen gör faktiskt onlineshoppingen mer mänsklig. De kan förstå kontexten, som att känna igen att ditt plötsliga intresse för trädgårdsredskap kan ha att göra med att du nyligen har flyttat. De kan skilja på ett engångsköp (som en bröllopspresent) och dina faktiska pågående intressen.

För företag är effekten enorm. Företag som använder dessa avancerade rekommendationssystem ser omfattande förbättringar av sin rekommendationsprecision. Detta leder till nöjdare kunder, bättre försäljning och effektivare verksamhet.

Bäst av allt? Det här är bara början. I takt med att dessa system fortsätter att utvecklas blir de bättre på att förstå inte bara vad vi köper, utan varför vi köper det. De lär sig att väga in allt från säsongstrender till personliga milstolpar och skapar shoppingupplevelser som känns mindre som transaktioner och mer som samtal.

Så nästa gång du blir positivt överraskad av en mitt-i-prick-produktrekommendation ska du komma ihåg att det inte är magi – det är kraften hos transformatorbaserade språkmodeller (LLM) som arbetar i bakgrunden för att göra din shoppingupplevelse bättre än någonsin. Inte bara ett modeord

Företag behöver i dag bli bättre på att förutse det bästa nästa produkten eller innehållet samt dynamiskt rekommendera och finjustera erbjudanden om de vill förbättra kundupplevelsen och fortsätta generera meningsfulla intäkter. 

I takt med att världen fortsätter att gå mot dessa avancerade algoritmer håller djupinlärning redan på att bli branschens förstahandsstrategi, och ersätter det begränsade rangordningsinflytandet från samarbetsfiltrering med mer personliga rekommendationer.  Och i takt med att språkmodeller blir vanligare kommer kunderna att förvänta sig ännu mer personliga rekommendationer. Endast de mest avancerade varumärkena kommer att vara redo att leverera.

Kontakta säljavdelningen

Prata med en expert för att ta reda på hur Mastercard kan göra din verksamhet ännu bättre med hjälp av våra produkter och tjänster.

Mastercard